11 月 4 日,CMU 的研究者在 arXiv 上發了一個叫 ServerBench 的新基準。假設你正跑着一套推理服務系統,有人拿一套 agent 設計的版本放到你面前,說它比你現在用的還強。你敢不驗一遍,就直接換到線上嗎?
這個基準找來 11 個 coding agent 模型(就是平時替你寫代碼的那種 agent),跑了三種部署,一共 33 次運行。每次都是讓模型獨立設計一整套 LLM 推理服務系統,再拿真實負載去跑、去打分。
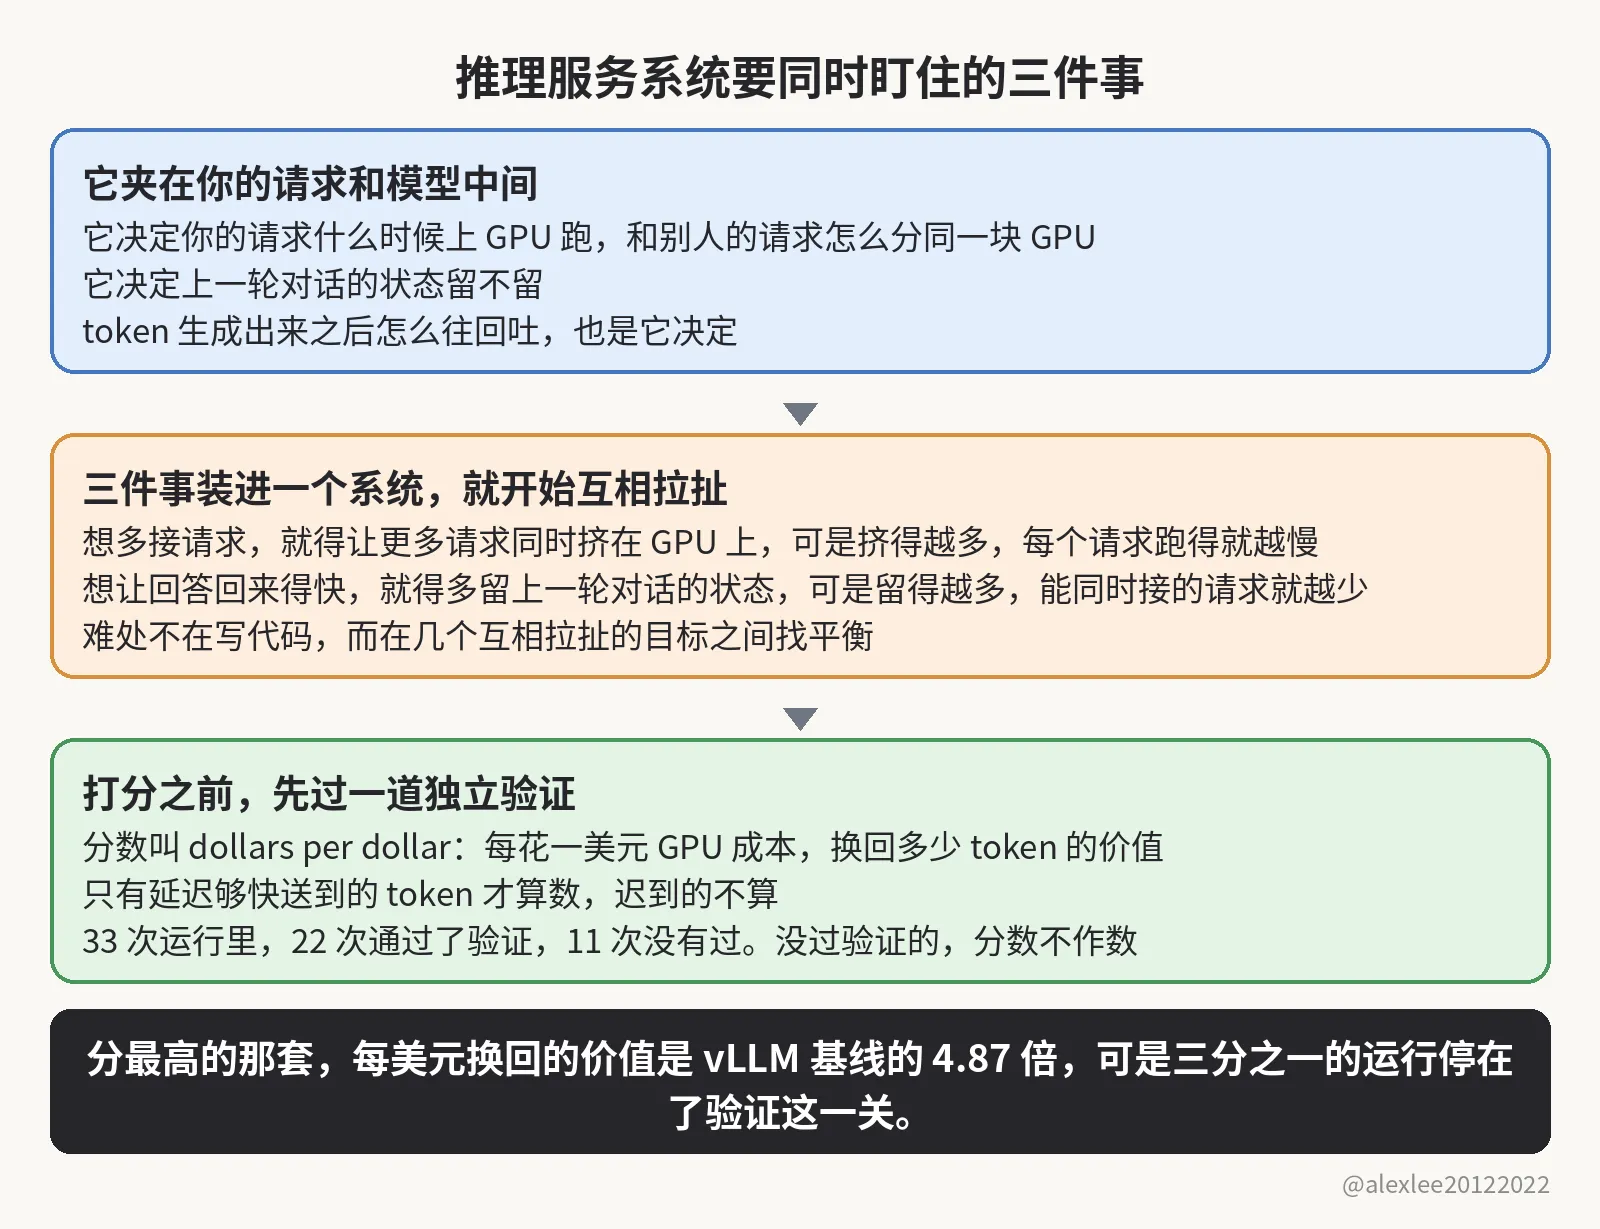
33 次裏,22 次交出的系統通過了驗證,剩下 11 次沒有過。分最高的那套,是 Claude Sonnet 5.5 在 Gemma E4B 上設計出來的:它每花一美元 GPU 成本,能換回 2.97 美元的 token 價值,算下來是 vLLM 基線的 4.87 倍。vLLM 是大家平時跑推理服務最常用的開源系統,所以同行默認拿它作參照。
你的請求發出去之後,先碰到的是推理服務系統,再由它送到後面的模型那裏。它決定你的請求什麼時候上 GPU 跑、和別人的請求怎麼分同一塊 GPU,因爲 GPU 就那麼大,所以分法直接決定你要等多久。它還決定上一輪對話的狀態留不留,因爲留下來,下一輪就不用從頭再算。token 生成出來之後怎麼往回吐,也是它決定,因爲吐得太碎會多花開銷,攢得太久又會讓你多等。
把它做好,要同時盯住三件事:第一件是系統一次能接多少請求,第二件是回答回來得有多快,第三件是回答本身對不對。只管一件事的函數不難寫,因爲它只要把自己那件事做對就行,而且它的輸入和輸出都是定死的。
可是三件事裝進同一個系統、放到真實流量下面,就開始互相牽扯了。你要是想多接請求,就得讓更多請求同時擠在 GPU 上,可是擠得越多,每個請求跑得就越慢。你要是想讓回答回來得快,就得多留上一輪對話的狀態。可是狀態佔着顯存,所以留得越多,能同時接的請求就越少。所以設計這套系統的難處,不在寫代碼,而在幾個互相拉扯的目標之間找平衡,ServerBench 交給 agent 的正是這件事。
打分的尺叫 dollars per dollar:每花一美元 GPU 成本,最後換回多少 token 的價值,分數就是多少。不過它給 token 算價值的時候加了一個條件:只有在延遲夠快的前提下送到的 token 纔算數,遲到的不算。
這個條件是用來防作弊的。要是不加,系統就能把回答拖着慢慢給。token 一個都不少,可是等答案的人早就等過頭了,遲到的 token 對他也就沒用了。除了延遲這一條,它還把真實會話連着上下文原樣重放,免得 agent 把每個請求都當成第一次見,靠丟掉上下文來省計算。每個系統交上來之後,還得先過一道獨立的驗證。只有驗證過了,它的分數才作數。
通過驗證的 22 次裏,有 13 次超過了論文所設基線中最強的那個。4.87 倍比的是 vLLM 基線,也就是前面說的那個大家最常用的系統。可是 13 次超過的那個最強基線,是論文另外設的。論文沒有說它就是 vLLM,所以這兩個數字不能混在一起看。
第一條發現:分最高的那些系統,都是兩件事一起做的。一邊把容量做大,也就是一次能接的請求做多。另一邊挑負載,先看一個請求要佔多少 GPU 時間、能換回多少 token 價值,再決定接不接。換得回價值的接進來,換不回的就讓它等一等,或者乾脆拒掉。
兩件事必須一起做,因爲只做一邊,另一邊就漏。光把容量做大也不行,因爲請求要是不挑,GPU 的時間就會花在換不回多少價值的請求上。而且容量越大,這樣浪費掉的就越多。反過來,你光會挑負載也不行,因爲系統本身一次只能接那麼幾個請求。你挑得再準,能換回來的價值也有個上限。兩件事一起做,多出來的容量才正好落在挑出來的請求上,分數就是這麼上去的。
第二條發現:agent 是靠做實驗、讀性能反饋來改設計的,所以實驗長什麼樣,它就學成什麼樣。你要是拿一套通用測試去調參數,因爲那套測試裏的流量形狀跟真實流量差得遠,那麼你調出來的參數一上真實流量就是錯的,等於實驗一直在教它錯的東西。論文裏說,反饋變得能用,是在實驗改成照着真實負載問哪裏慢之後。因爲哪裏最慢,只有真實負載跑起來纔看得見。
第三條是我最想說的一條,要是我在帶團隊,我會把它排在第一位。每次給系統做優化,都會在代碼裏多走出一條新路,而新路出錯的樣子,跟老路是不一樣的。所以論文說,優化帶進來的每條新路,都得單獨驗一遍,而且不能默認它跟老路一樣可靠。
速度這個東西,跑一遍就量出來了。對錯就不一樣了:你要是不專門去驗,那麼就算它把答案給錯了,你也看不見。所以一個只追分數的 agent,很自然就會拿對錯去換速度,因爲分數漲了,它就覺得自己做對了,除非旁邊有人專門驗它交出來的東西。一個系統完全可以跑得飛快,同時把答案給錯。
ServerBench 裏那道獨立驗證,攔的就是這個。33 次裏那 11 次沒通過的,就是倒在這道關上:交上來的系統過不了驗證,就等於沒交。要是沒有這道關,那 11 次裏跑得快的那些,分數就照樣好看,然後就會被人直接搬去用了。
三條發現串起來,是一個正在合上的圈:agent 開始設計跑模型的系統,而那套系統裏跑的模型,又在跑 agent。圈轉起來之後,做基礎設施的人,手藝的重心就得跟着變。親手把系統寫出來還是要緊的,因爲一套系統該驗哪些地方,得懂它的人才定得下來。可是接下來更要緊的,是能把一個又快又錯的系統驗出來,趕在它上線之前攔住。
所以 4.87 倍這個數字,我猜會傳得最遠,因爲它夠猛,又好記。可是我自己會記着的,是 22 和 33,因爲它們說的事更實在。33 次裏有 11 次交不出能通過驗證的系統,也就是說,整整三分之一的運行停在了驗證這一關。所以這個 4.87 倍,先當一家實驗室的結果看(數字是論文作者自己的,我自己也沒有重跑這個基準),別當定論。
你要是靠跑推理服務喫飯,那麼換上任何一套 agent 設計的系統之前,先回頭看看你自己的驗證辦法。它夠不夠攔住一個跑得快、答得錯的系統,換之前就得看清楚。要是這種把基準拆開講的文章對你有用,歡迎訂閱這個博客,或者先收藏起來。我接着寫跑在真實流量下的 AI 系統,也寫怎麼檢查它們。