6000 萬段資料的索引從 201GB 壓到 6GB,拿時間換空間這事兒靠譜嗎? 折騰過本地知識庫(RAG)的人都知道,最喫硬盤的往往不是模型,而是向量索引。
 原理其實很簡單:想讓 AI 查你的郵件、聊天記錄或者文檔,得先把資料切成小段,每段算出一串長數字(向量)存起來。問題來了,段落一多,這串數字佔的地方極大。6000 萬段維基百科資料,傳統做法建出來的索引要 201GB。很多人的本地部署就卡在這:模型跑起來了,硬盤被索引撐爆了。
伯克利 Sky Computing Lab 開源的 LEANN 給出了個挺狠的解法:不存完整向量了。
它只存一張精簡過的圖(標明哪些段落意思相近)和一份壓縮過的粗略數字。查資料的時候,順着圖先用粗略數字篩出幾個最相關的候選段落,再直接拿這幾段的原文,當場現算完整向量做比對。畢竟查一次只用得上幾段話,沒必要爲了備查把幾千萬段話的數字全存硬盤裏。
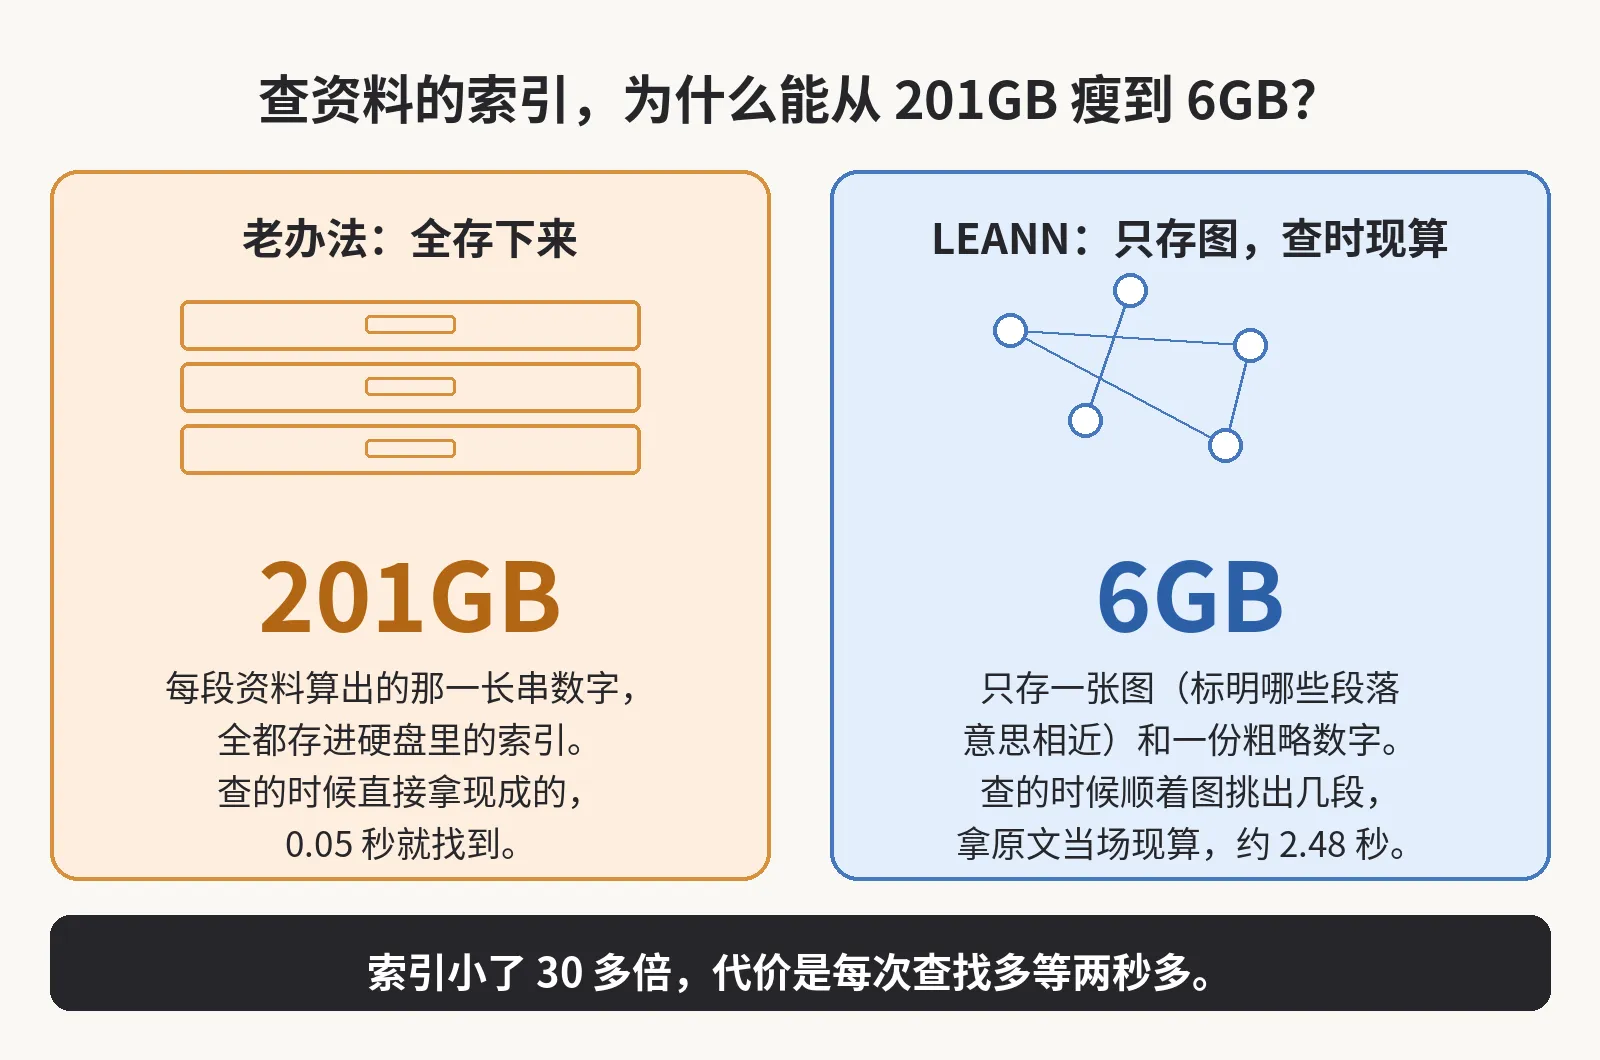 這麼搞下來,6000 萬段資料的索引直接從 201GB 降到了 6GB。換到個人場景也一樣:40 萬條聊天記錄的索引,從 1.8GB 縮到 64MB。準確率也沒掉。按官方公佈的標準問答測試(我沒自己復跑),新老辦法在同樣的召回率(90%,就是該找回的十段裏找回了九段)下,最終答題準確率都是 25.5%。
但代價是檢索變慢了。同一個測試裏,老辦法找資料只要 0.05 秒,LEANN 要 2.48 秒,慢了 50 倍。好在後面大模型生成答案本來就要 20 秒左右,總耗時從 20 秒出頭變成 22 秒多,平時自己用感知不明顯。但如果遇到要跨多段資料找線索的複雜問題,團隊在 Mac 上測出來光檢索就要 44.8 秒,這就真得乾等了。
所以這東西好不好用,全看場景。如果是自己電腦上跑私人資料庫,我肯定換,省下大把硬盤,多等兩秒完全能接受。但如果是很多人同時在線查的線上服務,這 50 倍的檢索延遲能不能扛住,就得先打個問號了。
覺得這種論文拆解有用的話,歡迎收藏這個博客,或者訂閱更新。很多論文只把好看的數字放標題,代價全藏在最後幾頁的表格裏。後面有空,咱們接着扒這些表格背後的賬。