aws 报的 75,000 个 agent 同时使用,看起来很牛逼是不是?但是实际上你不能这样看。这里说的是停放 75,000 个,而不是同时运行 75,000 个。这差异就非常大了。但是你要说这东西有没有价值?那么我认为有,而且我还挺看好的。因为它解决的正好就是 agent 最贵的那个毛病:等。
为什么说等是 agent 最贵的毛病?你想一下就明白了。一个 agent 真正干活的时间其实不多,大部分时间它都在等。查个数据库要等结果,调一个慢工具要等工具返回,等另一个 agent 干完,还要等真人去点那个批准。它明明什么都没干,可整段对话还得摊在内存里放着,而内存这个东西是按秒收钱的。你就放一两个 agent 在那儿等,无所谓。可你要是同时放一万个在那儿等,账单就很难看了。钱就是这么花掉的,而且花得你都没什么感觉。
那 infinity 是怎么解决这个问题的呢?说白了,它就是把等着的 agent 先存起来。agent 一开始等,它就把这段对话打包存进数据库,内存里的位子腾出来,给真正有活干的 agent 用。等结果回来了,它再把对话原封不动地搬回来,agent 就从刚才停下的那句话接着往下说,中间就像没断过一样。这么一存,一个等着的 agent 就只剩下 100kb 左右的一个小包袱。你算一下,100kb 乘上 75,000,那就是七个多 gb。一台内存 8gb 的树莓派 5,正好塞得下,aws 的演示就是这么演示出来的。当然了,你要是让这 75,000 个同时醒过来干活,树莓派肯定当场就趴下了,这个没什么好吹的。可是话又说回来,哪个车队里的 agent 不是大部分时间停着的呢?真正的负载,本来就是这个样子。
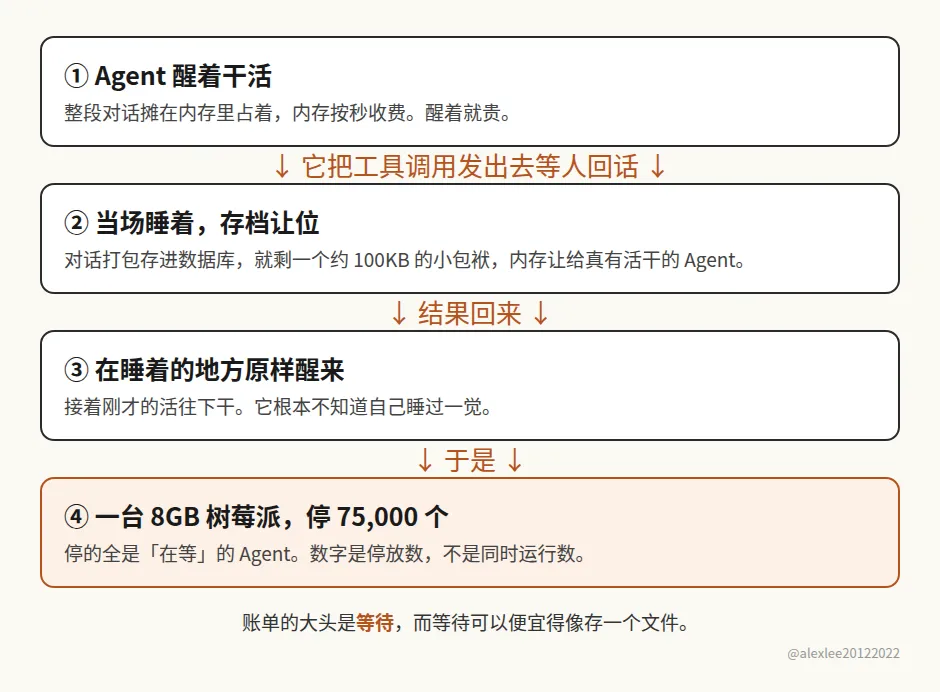
其实这招一点都不新鲜。操作系统几十年前就是这么干的:进程大部分时间在睡觉,那就先把睡着的挪出去,机器留给醒着的用。后来大家慢慢就不这么干了,因为进程太便宜了,全都醒着放那儿也花不了几个钱,省事。可是 agent 不一样,agent 贵。老办法就又值钱了。连怎么把 agent 叫醒,都是现成的套路:外面有消息要找它,infinity 就把这条消息扮成一个工具返回的结果,塞给它。它一收到,醒过来接着干活,根本不知道自己刚才睡过一觉。
你再往远了想一层。等待要是真的不要钱了,agent 的用法就完全不一样了。它就不再是跑完一趟就关掉的那种活了,它可以挂在那儿,挂上几天、几周都行,绝大部分时间睡着,偶尔因为一个工具的结果、一条新消息,或者一个真人点的批准,醒过来干一会儿,然后接着睡。到了那个时候,真正难的问题就不是怎么把 agent 跑起来,而是排班:一万个睡着的 agent,哪一个该先醒?醒过来的那一个,还记不记得自己睡着之前干到哪一步了?
话说回来,其实这东西本身就不是给普通用户和开发者使用的,因为我们通常一般同时用的 agent 也最多就是几十个就了不起了。真正需要这玩意的是 AI 行业的公司,或者内部已经开始大规模使用 AI agent 的那类企业。他们可能会同时运行成千上万的 agent,那么如何节省内存开销就成为了很实际的一个问题。所以,如果你是 AI 行业的从业者,或者你本身的工作涉及这块,我强烈建议你可以花一个下午的时间去试试看。如果你是和我一样的普通人,那么有时间可以阅读下它的代码,学习下它的思路,也不错。
最后想问问跑生产环境的人:你们的 agent 数量有多少?你们统计过那些 agent 真正醒着并干活的时间么?能占到一成吗?
出处:AWS 开源博客《Introducing Infinity》,2026 年 10 月 23 日,https://aws-news.com/article/2026-10-23-introducing-infinity-a-runtime-for-extreme-agent-concurrency