我在本機裝了 AWS Emulator 1.0.322。然後我在 SQS 上建了一個隊列。接着我把隊列列出來確認它已經建好。然後我往隊列裏發了一條消息。最後我把這條消息收了回來。整個過程沒有連真的 AWS。而且收回來的消息正文和我發出去的那條消息的正文一模一樣。
2026 年 11 月 11 日,AWS 發佈了這個模擬器。它在本機運行,而且它對外提供的接口和真的 AWS 一樣,所以你把 SDK 的地址指向本機以後,你就可以在本機測你自己的程序。
它覆蓋了 438 個 AWS API 模型,而且它的倉庫到今天已經有 30,627 次提交和 5,002 個星。官方博客的作者 Matthew Goldberg 寫得非常直接。他說全部代碼都是自主 agent 寫的。而且他說 AWS 的團隊沒有寫過一行代碼,也沒有審過一行代碼。
它是從一個週末實驗開始的
這個模擬器是從一個週末實驗開始的。Goldberg 先給負責寫代碼的 agent Kiro 寫了三步要求。他讓 Kiro 先按照 AWS CLI 的行爲寫測試。接着他讓 Kiro 把這批測試放到真的 AWS 上跑到通過。最後他讓 Kiro 再寫一份在內存裏運行的 SQS 實現,而且這份 SQS 實現也要通過同一批測試。
15 分鐘以後,第一版 SQS 實現就跑起來了。而且因爲週末結束的時候 Kiro 已經寫完了其餘服務,所以團隊在週一就開始用這個模擬器測他們自己的軟件了。
三支隊伍和一道合併門
後來團隊把工作拆成了三支隊伍。第一支隊伍專門寫測試。他們按照公開的 Smithy API 模型編寫真實的使用場景。他們先把每個場景放到真的 AWS 上驗證。驗證通過以後,他們才把這個場景存成保真測試。所以最後攢下來的保真測試有數以萬計。
第二支隊伍專門找問題。他們把保真測試拿到模擬器上重新跑一遍。他們把跑失敗的測試記成一個問題,然後他們把問題放到一個叫 things-that-do-not-work 的目錄裏。這個目錄就在倉庫的 issues 文件夾下面。
第三支隊伍專門修問題。每個 agent 只認領一個問題來修,而且每個 agent 修完以後都要把改動送進一道合併門,所以沒有通過合併門的改動進不了主線。
合併門一共查四項。程序先要能編譯通過。然後審查的 agent 要檢查寫法是否符合編碼規範。接着還要做安全檢查。負責安全檢查的 agent 要確認改動沒有引入安全問題。最後系統還要重新跑保真測試。系統要確認通過的數量沒有退步。團隊成員本人沒有審過任何一行代碼。門裏檢查代碼寫法和安全問題的工作由 agent 做,重新跑保真測試的工作則由系統做。
我把保真分數逐條數了一遍
我把 v1.0.322 這個 release 附帶的保真分數文件下載下來。然後我把這一份文件裏的記錄逐條數了一遍。這一份文件裏一共有 42,937 個測試單元。其中通過了 24,243 個,所以通過率是 56.5%。而且另外還有 18,614 個單元沒有通過。剩下 80 個單元被跳過了。
你把這個通過率看清楚以後,你就會發現它的測試根本沒有全過。而且沒有通過的單元佔了四成多。分數文件裏 SQS 一共 1,523 個單元。其中通過了 1,032 個,所以 SQS 的通過率是 67.8%。
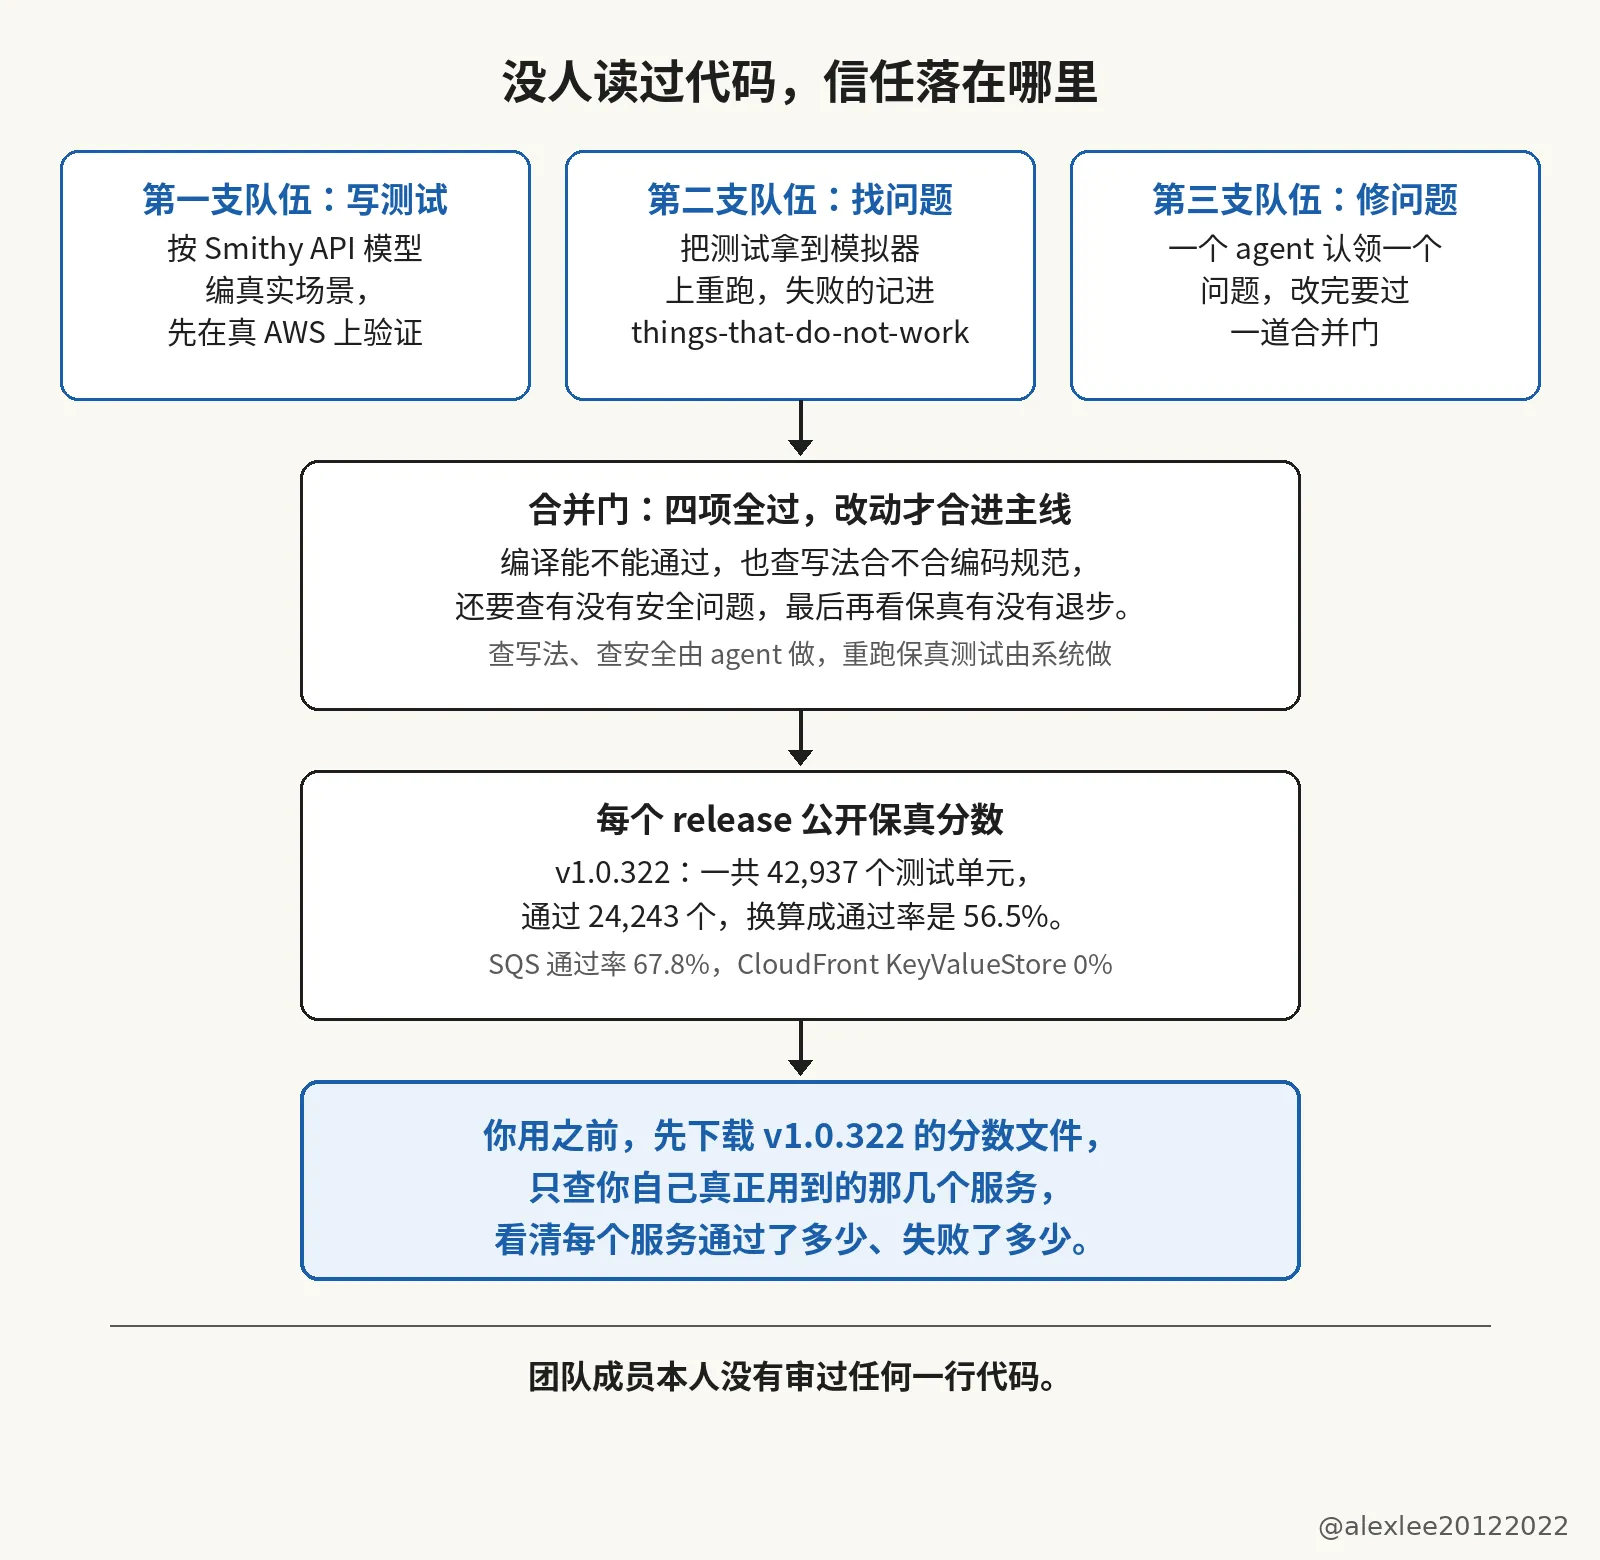
另外有些服務的通過率還要低很多。比如 CloudFront KeyValueStore 的 56 個單元一個都沒有通過。而且 EndUserMessaging 的通過率只有 3% 左右。EventBridge v2 的通過率也只有 3% 左右。
就算某個服務在這一份文件裏全部通過了,你也不能直接推斷這個服務就沒有問題了。因爲保真測試只能覆蓋測試編寫者已經寫出來的場景。所以沒有被寫進測試裏的行爲在分數文件里根本不會顯示出來。報錯細節和邊界情況也是一樣,它們沒有被寫進測試就不會顯示出來。
我開頭在 SQS 上做的建隊列、列隊列、發消息和收消息這四步也是同樣的道理。這四步都走通了只能證明這四個操作在模擬器上返回了預期的結果。其他沒有測到的操作仍然需要你自己另外去核對。
爲什麼 AWS 做成了,我的項目卻失敗了
這一點和我之前帶 agent 做遊戲的經歷正好能對上。那次做了兩個月,局部測試也一直在通過。但是遊戲整體離能玩越來越遠。所以我最後只能推倒重來。我把那次的完整復盤發在了這裏:https://x.com/alexlee20122022/status/2120832897825529896
兩次經歷放在一起看,爲什麼我失敗了,而 AWS 卻能用多 agent 協調開發做出一個能用的東西?
關鍵是 AWS Emulator 本來就是一個模擬器,所以它的範圍邊界在一開始就確定了。它既有真實數據可以對照,也有真實接口可以對照。輸入和輸出接口都已經由真實系統定好了。就算代碼量再大、內部實現再複雜,agent 也有明確的驗收標準。這個標準就是把模擬器的行爲對齊真實系統。
在這個邊界裏面,方向自然漂移的問題就不太存在了。它更可能留下的是另一類問題,比如重複代碼和重複邏輯寫了一大堆,內部性能有問題,安全問題也可能不少。但是至少,方向漂移不會把它拖到跑不起來,因爲每個結果都能拿真實系統來驗。
我的項目完全不一樣。《漢末行記》是從零開發的,沒有現成的真實系統可以參考,也沒有真實數據和真實接口可以對照。項目邊界沒有被一個已經存在的系統定住,我手裏只有設計文檔。agent 爲了達到設計目標,在實現過程中就會不自覺地漂移。這樣做下去,整個方向都可能偏離。
用之前先處理兩件事
你在用這個模擬器之前還有兩件事需要先處理。第一件是遙測。遙測默認是打開的。所以我啓動的時候加了 —telemetry off 把遙測關掉。而且你也可以通過環境變量把遙測關掉。你也可以通過配置文件把遙測關掉。
第二件是用途。README 裏寫明瞭它只供搭建和測試使用。所以你不要拿它跑生產負載。你也不要拿它來測安全問題。而且這個倉庫不接受 PR。所以你發現問題以後只能去報 issue。
先做兩步覈對,再把日常測試切過去
如果你準備在自己的項目裏用它,我建議你先做兩步具體的核對。你先把 v1.0.322 的分數文件下載下來。然後你只查你自己真正用到的那幾個服務。你要看清每個服務通過了多少,也要看清每個服務失敗了多少。
接着你把你項目裏每天都會用到的幾個場景挑出來。你把這些場景分別在真的 AWS 上跑一遍。你再把同樣的場景在模擬器上跑一遍。你把兩邊的返回和報錯逐條對完以後,你再把日常測試切到模擬器上。
我會繼續寫我自己動手裝過和測過的項目,並且把測出來的數字寫在文章裏交代清楚。如果你也在用 agent 寫代碼,而且這篇幫你把測試的數字看得更準一點,歡迎訂閱這個博客,或者把它收藏起來。