港大一個開源 AI 家教,倉庫建起來第 4 天就有 1,369 星。十個月後逼近 5.4 萬,其中 5,700 多是最近四天漲的。我 10 月 28 號把它的 v1.7.0 裝上真跑了一遍,稿子還沒寫完,10 月 31 號,v1.7.1 又發佈了。
這一篇篇幅不短,結論先放這兒,理由在後面慢慢擺:DeepTutor 的核心,一份結構化的錯題記錄加一套圍着它轉的出題循環,是這個團隊自己做出來的東西。但恰恰是這一層,在 2026 年一個 agent skill 就能復刻。它復刻不了的,是核心周圍那一整圈東西,而 5.4 萬星主要星的是那一圈:一個平臺、一種不懂技術的人也能裝能用的交付形態,外加一個會發新項目的實驗室。
你要是個自己學東西的技術用戶,這一圈你可能一樣都不需要。這篇講的就是這條界線劃在哪。
現在的聊天框到底記得多少
普通聊天框早就不是兩年前的水平了。要測一個家教的記性,得先看清它現在到底什麼水平。同一個對話裏你前面說過的話,模型本來就看得見,這一點從來不用懷疑。
換個新對話呢?幾家大平臺現在都給自己加了跨會話的記憶層。ChatGPT 有 saved memories,專門存它記住的關於你的事實,另外還能在回答時翻你過去的聊天記錄。Claude 的記憶在消費版是默認開着的,學到的東西按主題存成文件,你能打開看,也能改。Gemini 也有一個 Memory 設置,會從你過去的對話裏學。
細節各家不一樣:Claude 對敏感話題默認不記,Gemini 的記憶要開着 Keep Activity(活動記錄)纔有。
所以「聊天家教是條金魚,關掉窗口就把你忘了」這幅畫面,放到 2026 年已經不成立了。
但是它記的東西是什麼,同樣得說清楚。OpenAI 自己的幫助頁寫得很直白:記憶不會保留每段對話的每個細節,記哪些、忘哪些,是 ChatGPT 自己判斷哪些相關。平臺記下來的,是一個好助理會記的那類東西:你的偏好、你在做的項目、你的水平大概在哪。
學習記錄要細得多。它不是「這個人物理弱」這種話。它是:哪幾天、做了哪幾道題、透鏡公式的符號丟了兩次、像距混了一次、上週二同類型的題終於連對三道。有這樣一份逐條記下來的記錄,出題的程序纔有東西可算。偏好寫成一段話,是驅動不了這些的,因爲那些具體的事,根本沒有被逐條寫下來過。
核心:一份出題程序能算的記錄
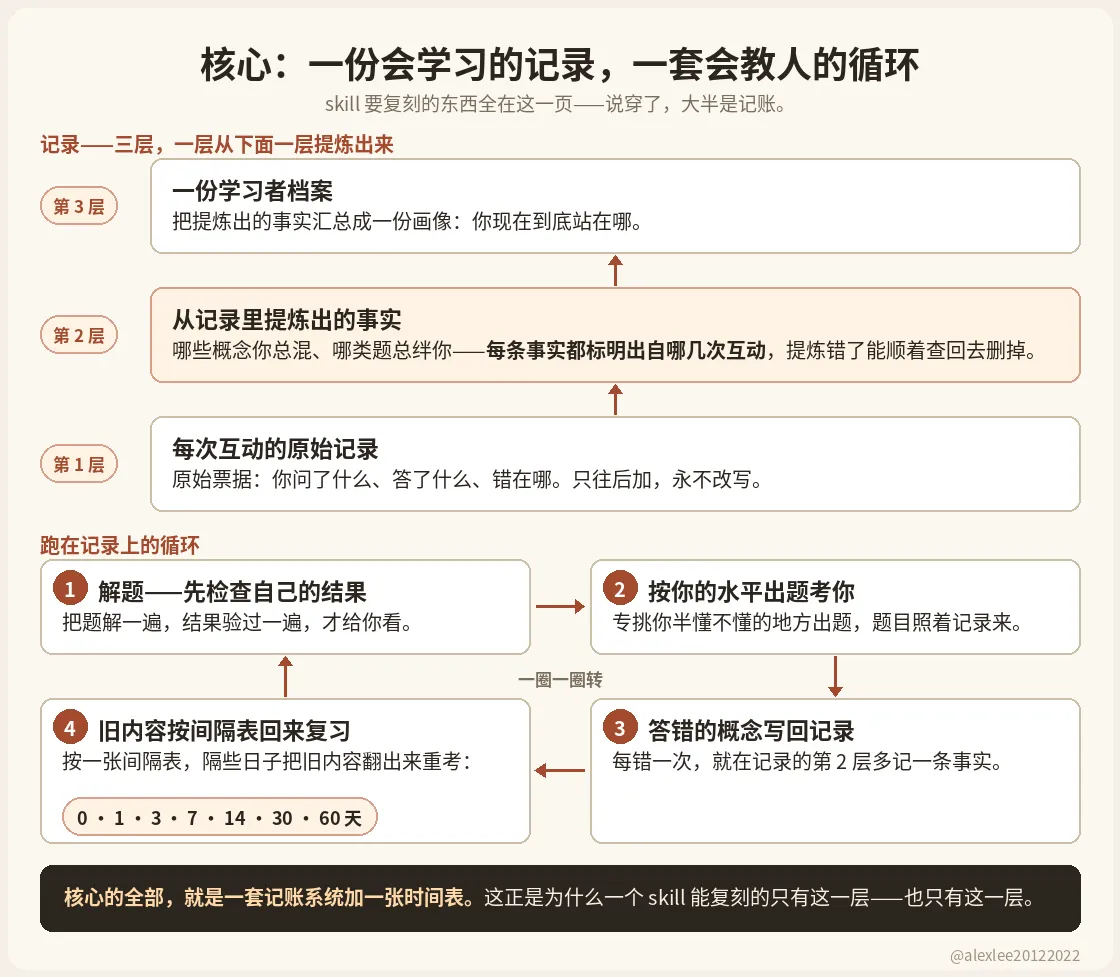
DeepTutor 是港大數據科學團隊做的,它把上面說的那種細記錄,建在你自己的機器上。記錄分三層。最底層存每一次互動的原始記錄,只往後加,永不改寫,就像會計留着原始票據。中間一層把原始記錄提煉成關於你的事實:哪些概念你總混、哪類題總絆你,每條事實都掛着它是從哪幾次互動來的,所以哪條提煉錯了,能順着查回去刪掉。最上面一層把這些事實合成一份你的學習畫像。
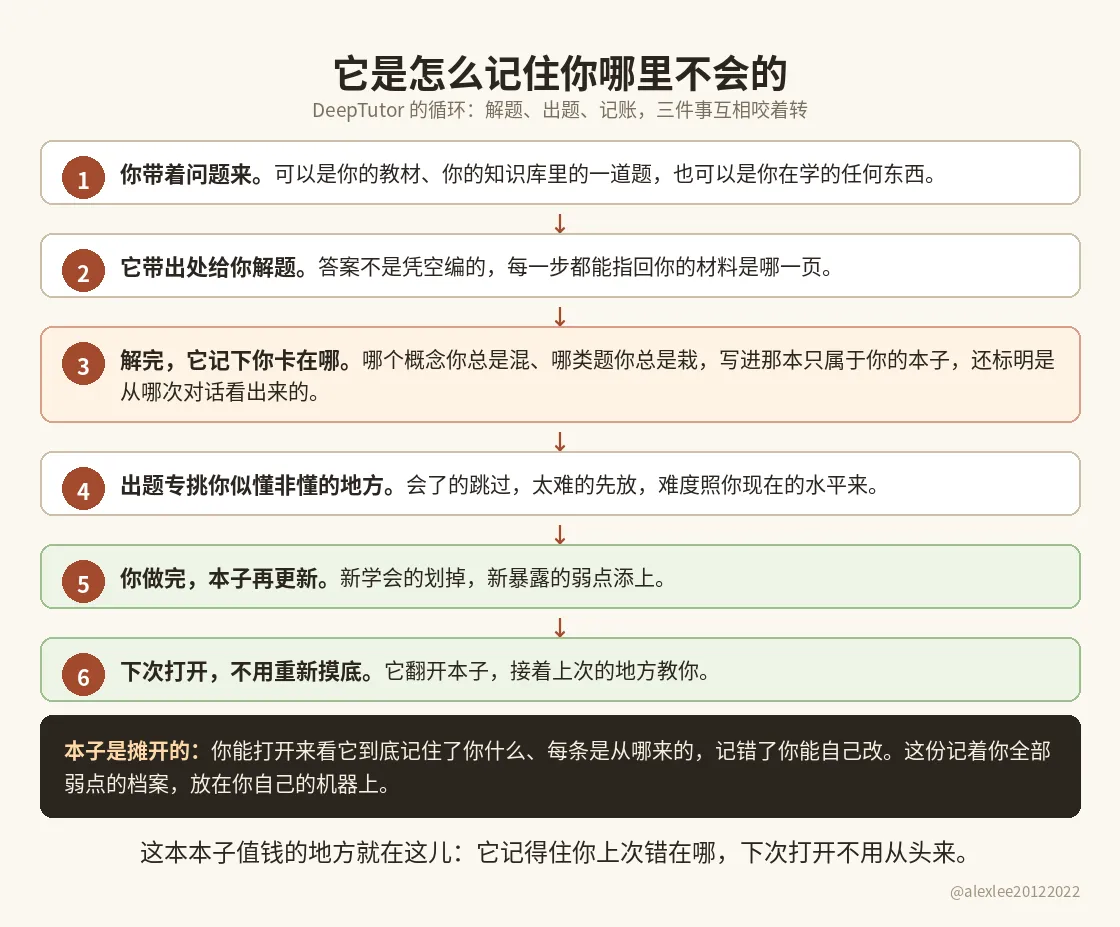
記錄上面跑着一套循環。你讓它解一道題,它先判斷這是什麼類型的題,解一遍,再把結果驗一遍纔給你看。然後它回過頭來考你,難度貼着你現在的水平出,你答錯的那個概念被寫回記錄裏去,下次問什麼,就受這條記錄的影響。還有個調度器管舊材料什麼時候回來複習,不同種類的知識,間隔不一樣。解題、出題、記賬、到期重考,這套循環配上這份記錄,就是這個產品的核心,也是大多數聊天家教確實沒有的那塊。
核心恰恰是 skill 能復刻的那一層
上一節講的東西,說穿了是一套文件格式加一份操作說明。你給現在的大模型 agent 一個 skill 文件,寫明記錄分三層存、出題照着記錄來、錯題按這個間隔表回來複習,再指給它一個本地文件夾,它就能跑出一個大體一樣的循環。間隔複習本身就是一張間隔表加一個到期隊列,這個代碼庫裏的調度器是紮實的工程,不是魔法。
單人、技術用戶、在自己天天用的工具裏學東西,skill 版能把核心這層的大部分事辦了。項目方自己的材料和外面的報道我都看了,沒有哪份正面回答過這一條,因爲這一條對核心來說,就是對的。
那問題就反過來了:核心要是裝得進一個 skill 文件,這個倉庫裏剩下的 33 萬行 Python 和 33 萬行 TypeScript 是幹什麼的?真正的產品在那兒。
核心周圍的那一圈
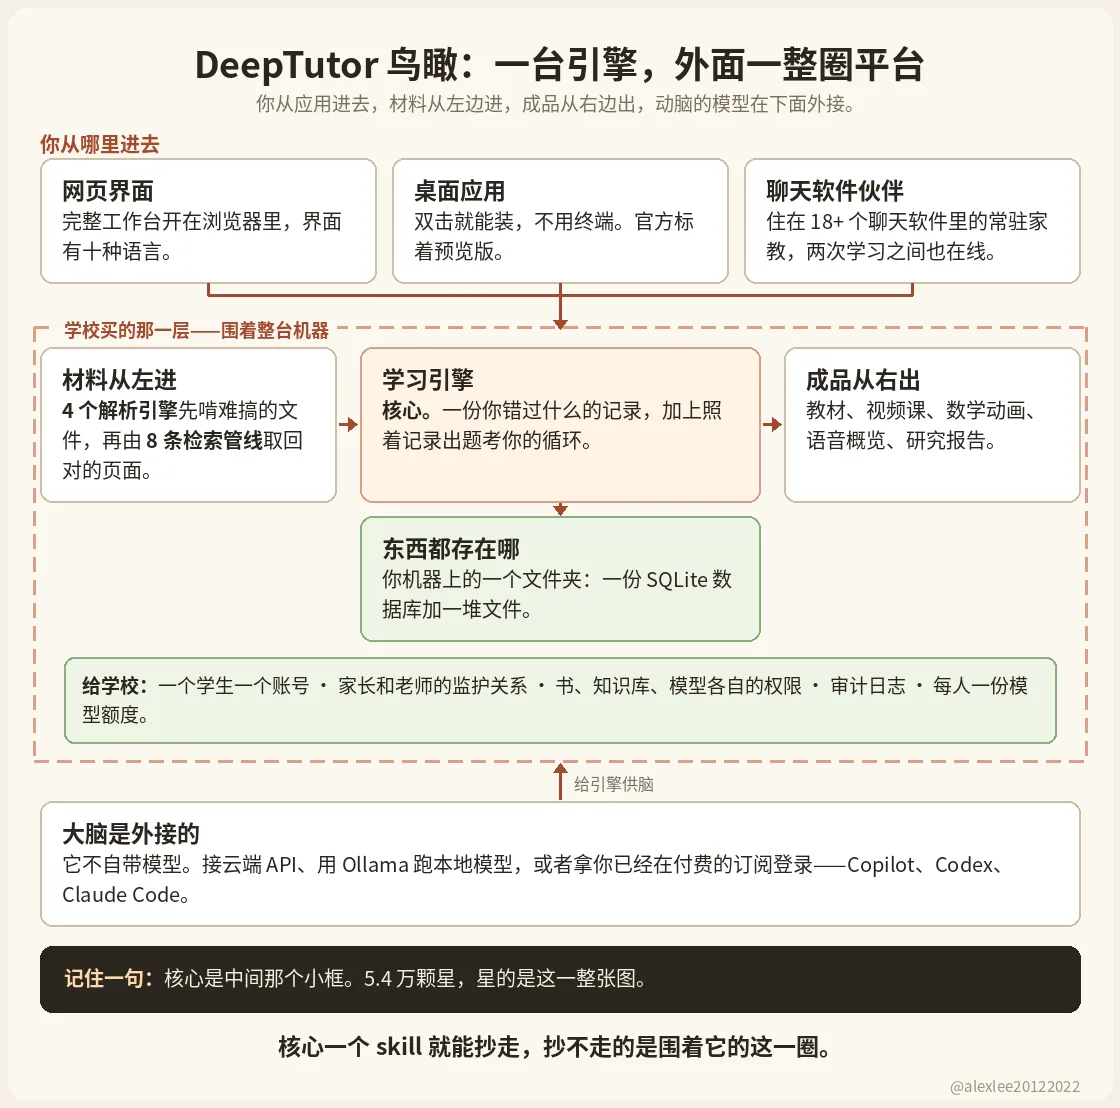
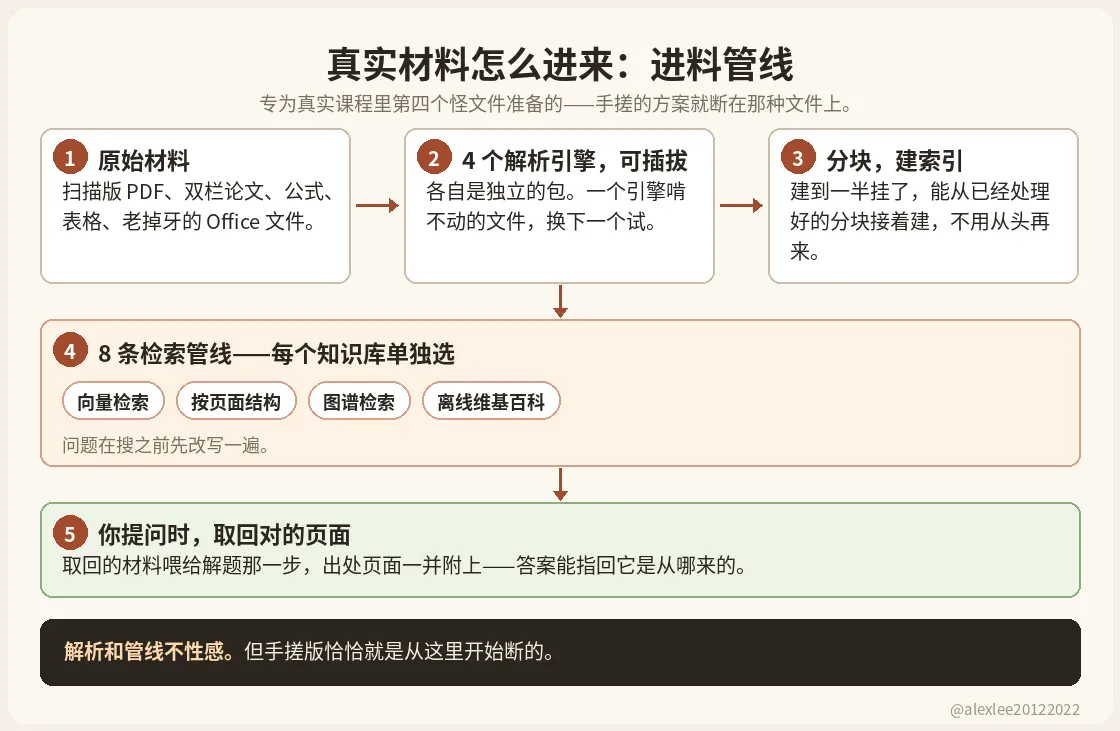
真實的學習材料是很難看的:掃描的 PDF、雙欄論文、公式、表格,老到能投票的 Office 文件。DeepTutor 自帶 4 個可換的文檔解析引擎,各自是獨立的包,一個引擎啃不動的文件可以換一個試;它的建庫管線斷在一半能從已經處理好的部分接着建,不用從頭再來。
解析後面坐着 8 套可換的檢索管線,不是一套:向量檢索、按頁面結構檢索、圖譜類的、離線維基百科的,每個知識庫可以單獨選,查詢進來之前先改寫一遍。skill 能給你乾淨的文件接一個解析器加一個向量庫。真實課程裏的第四個怪文件,就是手搓版開始斷的地方,而這個項目明顯在這些文件上斷過又修好過,反覆很多次;它的 issue 區躺着的正是這類 bug、這類用戶。
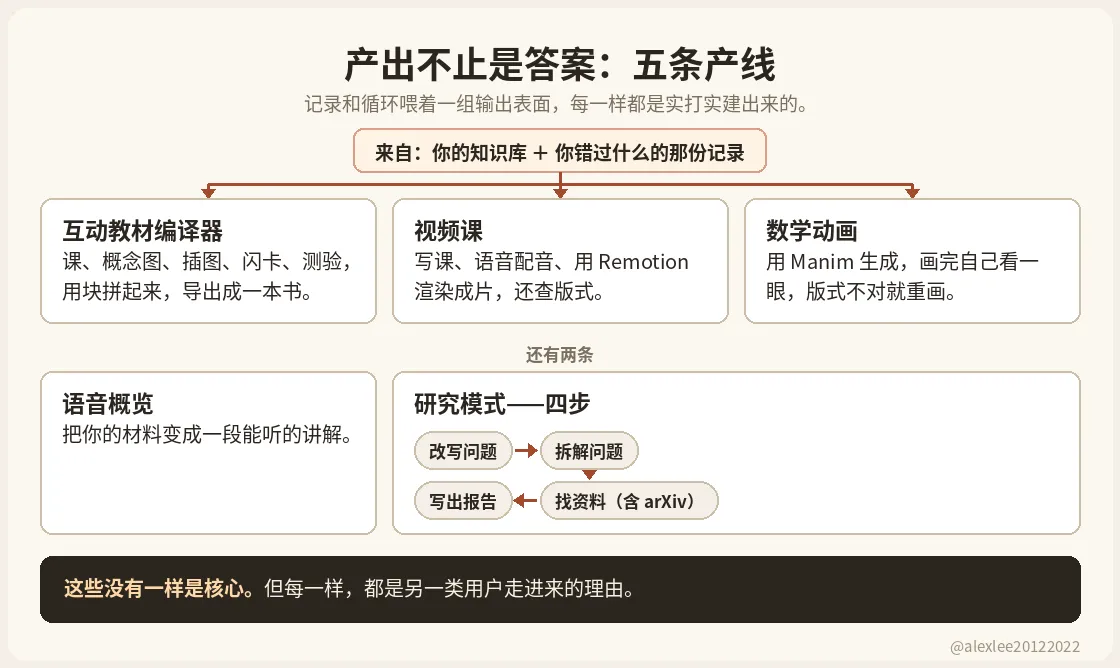
記錄和循環喂着一組輸出表面,每一樣都是實打實建出來的。互動教材是個編譯器:課由塊拼成,概念圖、插圖、動畫、測驗、閃卡、互動元素,拼完能導出成書。視頻課是一條管線:寫課、語音合成配音、用 Remotion 工程渲染,還查版式。
數學動畫用 Manim 渲染,渲染完它自己看一眼,版式不對就重試。還有個音頻概覽,能把你的材料變成一段能聽的講解。還有個研究模式,把一個問題拆開去查,來源包括 arXiv 的論文,最後寫成一份報告。筆記本重做成了頁和塊,配了個編輯助手,它的改動要你點頭才落地。這些沒有一樣是核心。但每一樣,都是另一類用戶走進來的理由。
DeepTutor 有個「夥伴」系統:一個常駐的家教夥伴,住在 18+ 個聊天軟件裏,微信、QQ、釘釘、飛書、企業微信、Telegram、WhatsApp、Slack、Discord 等等,還有夥伴羣。學生可以在自己天天用的聊天軟件裏學,夥伴在兩次學習之間也在線,這是對話窗口做不到的在場方式。
skill 是會話形狀的,你跟 agent 說話的時候它纔在。18 個網絡上常駐的夥伴是服務,要維持連接、要主動推送,是另一個物種的軟件。
多用戶這一層是機構級的:賬號、家長或老師跟學生之間的監護關係、按資源分開的授權(書、知識庫、模型、技能各管各的)、審計日誌、設備憑證、個人模型配額。光這一層的測試文件就有 38 個。學校不會採用一個文件夾加一段提示詞,它要麼採用賬號、權限和審計這一套,要麼根本不採用。
它的供應層除了常規的 API 商家和本地 Ollama,還做了訂閱型的:Copilot、Codex、Claude Code 走設備登錄的 OAuth,用戶拿已經在付費的訂閱就能跑,不用另開按量計費的 key。桌面端是 Mac 和 Windows 的雙擊安裝,內置運行時,點開就把整個 Web 界面起起來,用戶不用碰終端、不用裝 Python、不用 Git。
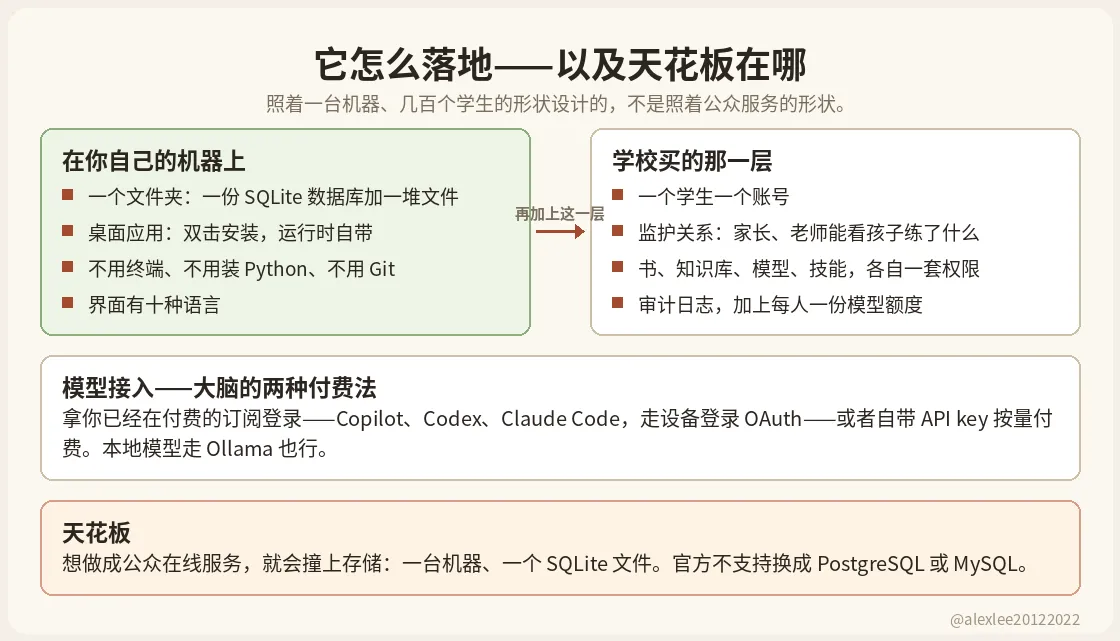
界面有 10 種語言,翻譯的一致性有自動檢查盯着。全倉測試文件 905 個。這些你可以嫌口味,但不能管它叫套殼。
skill 和平臺的關係,最能說明問題的一個證據,在它自己的服務層裏。DeepTutor 內置了自己的技能註冊表,一套裝技能的樞紐;倉庫根目錄還自帶一份 SKILL.md,全部內容就是讓外部的 agent 通過它的命令行來驅動它。在這套架構裏,skill 是蓋在平臺上的一層插件,其中一份 skill 乾脆就是這個平臺的遙控器。「一個 skill 就能做」這句批評,把從屬關係說反了。
到底能不能用起來
我裝了它、拆了安裝、讀了代碼和發佈說明、讀了團隊的論文。我沒有接上模型,真的拿它學上一個月。所以誰拿一次安裝測試給你下「長期學習有沒有用」的結論,你都別信,我的也不行。
裸裝 v1.7.0 的 core,約兩分半鐘,裝完佔 190MB,依賴檢查干淨。core 裏只有對話、命令行和 SDK,截圖裏人人看的那個 Web 界面是另一套更重的安裝。模塊目錄一共 25 個,解題、出題、知識庫、記憶、筆記本都在裏面。
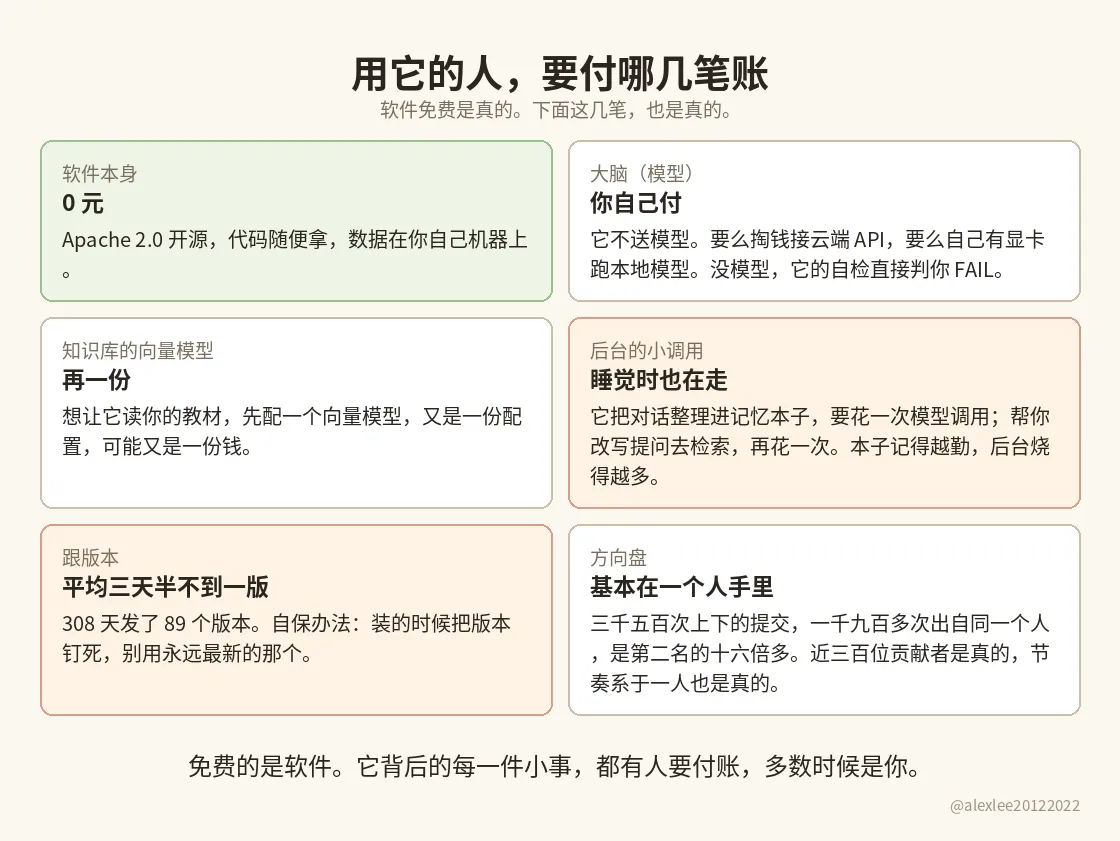
裝完乾的第一件事,它用自檢命令 doctor 當面判了我兩個 FAIL:沒配對話模型,沒配向量模型(把教材和題目轉成可檢索數字的那個,知識庫靠它找材料)。它不裝「一切就緒」,缺什麼當面說清。條件也就擺在這裏了:開箱的 DeepTutor 什麼都幹不了,模型、API key、預算,你得自己帶。
這還是在終端裏手動裝 core 的路。桌面安裝包存在的意義,正是它的大多數目標用戶會在這幾步裏的第一步就停下來。
用起來的持續成本是結構性的,不是偶然的。軟件本身免費,Apache 2.0,代碼隨便拿。模型不在裏面。你每問一句、它每驗一步、每出一次題,都是真金白銀的一次模型調用。還有些調用是藏在後臺的:一節學完,它要再調一次模型,把剛發生的事提煉進記錄;你下次提問之前,它可能先拿記錄把你的問題改寫一遍再問。記錄維護得越勤,後臺的模型調用就越多,賬單跟着漲。
再往上是維護的賬,這個更磨人:這個倉 308 天發了 89 個版本,平均三天半不到一版,光 9、10 兩個月就 15 版;我裝的版本三天之後就被 1.7.1 頂了,桌面預覽版、多了四種界面語言一起進來。
1.7.0 升級說明裏埋的那個坑,在 1.7.1 的升級說明裏原樣還在:機器上要是還留着舊的命令行安裝包,先把它卸掉,不然你可能付了新版的代價,還在跑舊的。1.7.1 我沒裝,這篇裏所有上手實測的都是 1.7.0。
方向盤也基本在一個人的手裏。GitHub 統計,貢獻 3,205 次、268 個賬號,其中約 1,900 次出自同一個人,佔了六成上下,是第二名 116 次的十六倍多。這個人後面有一條真實的尾巴,貢獻 5 次以上的賬號有 49 個,所以它不是一個人的倉庫。這個人要是停下來,三天半一版的節奏就跟着停,你的維護問題就變成存亡問題。
它到底爲什麼這麼火
上面這些加起來,也解釋不了 5.4 萬星的形狀:建倉 4 天 1,369 星,寫這篇之前四天又漲了 5,700 多。光靠產品質量,長不出這種曲線。它的走勢是臺階型的,一級一級跳,臺階是有機制的。
第一級是門上的招牌。這個實驗室就是做 LightRAG 的那個,LightRAG 自己有 4 萬星。英文報道寫 DeepTutor,開頭幾行就要提一遍實驗室的履歷。新項目從這種實驗室出來,起點不是零關注,是現成的訂閱盤。也要說清這個背書是什麼、不是什麼:它是一個受尊敬的實驗室的牌子、一篇論文、一個項目官網。我沒查到港大校級層面的官宣,而它起飛也確實不需要。
第二級是節奏在喂榜單。三天半發一版,等於每三天半把倉庫重新推到 GitHub 日榜面前一次,榜單再把它推給下一波星星。漲得最猛的一天是 10 月 29 號,單日 2,300 多星,緊跟在 1.7.0 發模塊化安裝和桌面預覽之後。發佈節奏就是它的市場部。
第三級是它站的品類位置。有位評論者把話說得很直:這是自託管的信號,不是家教的信號。大廠聊天應用在自家雲裏免費答題的市場裏,「材料是你的、記錄是你的、機器是你的、模型你自己選」,是很大一羣人願意表態支持的位置,而點星就是這羣人的表態方式。成品的形狀也對同一羣人重要:開源家教大多停在演示或庫,這個是能當產品裝的。
第四級是配套廣本身。各子系統是各自獨立的門:視頻課傳播給一批人,數學動畫給另一批,研究模式給第三批,聊天軟件夥伴給第四批,記錯題的故事給第五批。一個窄工具只有一個被世界注意到的表面。這個有十幾個,而且「什麼都有」本身就是中文報道里現成的標題。
使用不是零:它的安裝包在 PyPI 上,10 月最後一週每天被下載 1,200 到 1,950 次;issue 區 30 天新開了 202 條,讀起來全是真用戶在真機器上的問題,桌面端找不到本地裝的工具、某個供應方在 Windows 上失敗、舊 Office 文件傳得上去卻在解析時死掉。
但我找不到任何一傢俱名的學校或機構出來說它在給自家學生用這個;它的 6,692 個 fork 裏最大的一個只有 26 星,真是被採用的平臺,fork 不長這樣。所以這 5.4 萬最準的讀法是:一大羣圍觀者,一個真實且在長的用戶少數派,和一個還沒發生的機構故事。
論文裏的兩個數字,放在它們該在的位置
它有一篇港大自己發的論文,摘要裏兩個數字傳得很廣。這兩個數字是支撐材料,不是結論,而且標籤一個都不能摘。
10.8% 出自它自建的基準 TutorBench:模擬學生,學的是大學課程材料,系統給出的講解和練習題由另一個大模型按評分表打分,3.91 比 3.53,滿分 5 分。這個量的是模擬互動裏教學產出的質量分,不是學習成績。沒有真學生先測一次、用一陣、再測一次的那種數據。
29.4% 更要看清。它出自另一組實驗:DeepTutor 的解題去比四個基線,那四個基線是作者自己寫的簡單家教;而且就在這組實驗裏,它主打的那臺個性化引擎,全程是關着的。這個數字再好,跟「記不記得住你哪裏不會」也沒有關係。
論文自己其實很老實。它的限制部分明說,評估建立在模擬學生之上,那些擴展功能到底能不能讓人學得更好,需要拿真人做長期研究。摘要把話說得大,正文把醜話留在了找得到的地方。你按它自己的醜話來要求它就行。
它到底適合誰
你要是正在系統地學一門課,備考,或者啃一本厚教材,而且三個月後你還在這件事上,整個平臺對你才掙得回它的分量:材料走它那些能伺候怪文件的解析器,記錄一節一節攢,出題從你真實的水平出發。這種用法我建議裝,裝完整版(安裝時選 full),走 Docker 把環境固定住,版本釘死,不要用那個永遠最新的 latest。釘版的意思是放棄每三天半落下來的新功能,一門幾個月的課,這個價付得值。
你要是教書,或者開個小學校、教培機構,你要的是另一層:賬號、監護、授權和審計。這一層是聊天應用和 skill 都壓根不給你的,而且它明顯就是照你的形狀做的,一個學生一個賬號,材料由管理員統一發,家長能看孩子練了什麼。
要用它的人要是不住在終端裏,你的理由是桌面安裝包和聊天軟件夥伴。就盯一件事判:學生到底會不會打開它。一個住在學生天天聊天的軟件裏的家教,比一個儀表盤多的是真實機會。
你要是自己學東西的技術用戶,別裝,去寫 skill。記錄格式和出題循環,恰好是真能改變你學習結果的那部分,它們裝得進一個 skill 文件加一個文件夾,跑在你已經在用的 agent 裏,沒有 Docker 棧,沒有版本跑步機,沒有第二套要養活的系統。你放棄的是教材編譯器、視頻課、夥伴和機構層,你要是本來就不會用它們,你什麼都沒放棄。
你要是隻想把今晚的作業問明白,那就兩個都別碰。你現成的聊天應用記得你的水平、你的偏好,對這種用法已經夠了,還不用你搭任何東西。
給孩子用
能不能幫孩子提高成績?有可能幫他補上某個具體弱點,但到今天爲止,項目方沒有證明過它能把考試分數提上去,更沒有證明過它能替代家教或補習班。我的建議很直接:拿它當補弱點的練習教練,先別因爲它退掉真人課。
證據的情況就是論文那一節的情況,換到孩子身上不會自動變好:模擬的大學學生、大模型打的分,不是孩子的分數動了。它能幫上忙的地方是練習更有針對性:孩子錯在哪的記錄攢下來,下一次練習就照着弱點來,一個錯過的題型更容易在考試之前再碰到,而不是考完才發現。這條路有個前提:孩子得肯自己坐下來練。
它的監護層倒給了聊天應用不給的東西:材料可以由家長指定,報告能打開看,你能覈對孩子到底練了什麼。只是要分清:報告能證明孩子坐下來用過,不能證明孩子學會了。
但好家教的本事不止講解。他坐在孩子對面,能看見孩子是真不會、亂猜,還是已經走神了;他知道學校老師下週講到哪、考試壓在哪幾天,也會在孩子想抄答案時當場攔下來。DeepTutor 看見的只有孩子打出來、傳上去的東西。
補習班賣的也不只是題和講解,還有排好的課表、固定的時間、限時考試和一屋子同學的壓力,這個節奏它替孩子守不住。
你要判斷它對你家到底有沒有用,就用閉卷測法:選一個弱項,沒見過的題先測一次,只喂這一單元的材料練兩週,再換一組新題閉卷測,學校小測跟着看。分數動了,可以考慮少上一部分一對一;沒動,就當它是個答疑工具,提分的話一句都別信。低齡孩子也別單獨放給它,內容對不對、是不是在抄答案,還是得有人看。
拿它做生意
能,許可證這一關它是敞開的。Apache 2.0,商用、改、在上面做收費產品都行,保留它原來的許可證聲明,改過的地方標明,唯一不送的是商標,名字和 logo 不是你的,不能打着它的牌子賣。做教培的,它的多用戶就是給你這種場景準備的:每個學生一個賬號,工作區、進度、對話互相隔開,你作爲管理員統一發材料、管權限,還有剛纔說的監護關係。一家機構帶自己幾百個學生,是它設計時就想好的用法,不用你硬湊。
但你要是做開發的,想把它當底座,搭一個面向公衆的 SaaS 平臺,先去翻一翻它的數據是怎麼存的。它所有的狀態都存在一臺機器的一個目錄裏,數據庫是 SQLite 加一堆文件,官方文檔明說沒有支持的 PostgreSQL、MySQL 接法。
用戶少的時候,這種存法是簡單;用戶上了量,它撐不住,數據層得你自己重做。再加上版本那道選擇題:要麼釘死一個版本,從此跟上游越走越遠,分叉的賬你自己還;要麼跟着它三天半一版往上升,每次升級都是一次迴歸測試。兩條路選一條,沒有第三條。
1.7.0 改了什麼,1.7.1 又改了什麼
你現在真去裝,裝到的已經不是我測的那個版本了,所以簡短交代一下差別:1.7.0 把安裝拆成模塊,學習工作區和筆記本重做成頁和塊、配了一個能討論段落的編輯助手,加了能在瀏覽器裏放的視頻課,還讓建到一半死掉的知識庫能從斷點接着建。
三天之後 1.7.1 加了 Mac 和 Windows 的桌面預覽版、多了四種界面語言、一批聊天和課程的修補,升級說明裏舊包先卸的警告一字沒改。你要裝,就是裝進這麼一條河裏。裝之前先想好:你是順着它一版一版走,還是釘死一版過自己的日子。
模型只會越來越便宜,也越來越會講題。核心也會越來越便宜:凡是文件格式加一套循環的東西,一個季度之內就會被 skill 吸收掉。
吸收不掉的,是核心外面那圈不體面的東西,伺候真實文件的解析器、給每種人用的表面、給機構用的賬號和權限,還有一個人守着它一週發三個版本。
下次再看到一個星數嚇人的 AI 工具,我建議你就給這一圈估價:不看招數巧不巧,看它包裝給誰、插進什麼、圍着它的人是在用還是在鼓掌。
DeepTutor 的記錄回答了家教必須先答的第一個問題。它的平臺回答的是第二個。而鼓掌的人數和真用的人數,從來不是同一個數,把這兩個數分開,是這行當裏大半的功夫。
覺得這類拆解對你有幫助的話,歡迎訂閱或收藏這個博客,我會繼續用裝之前想看清楚的標準,拆 AI、安全和開源工具。最後問一句:你裝過最重的一個工具,後來發現一件小事一個腳本或者一個 skill 就能辦,或者正好反過來,有嗎?
原文/項目:https://github.com/HKUDS/DeepTutor/releases/tag/v1.7.0