我照規格復刻了一個 1.47 MB、76 萬參數的 agent 意圖路由器,跟 if 判斷比賽,它輸了
10 月 31 日,一個叫 @openrunt 的小賬號發了一份文件檢查報告。他截圖裏的工作日誌顯示,這次檢查花了 1 分 8 秒,查的是一個 1,542,912 字節、約 1.47 MB 的 GGUF 文件,文件裏裝着一個完整的模型。
這個模型叫 Xputty Shadow Core 0.1,是一個意圖路由器:讀一句話,判斷說話的人想幹什麼,再把這句話送去對應的工具。帖子裏沒有下載鏈接,也沒有模型頁面,文件本體沒法測。
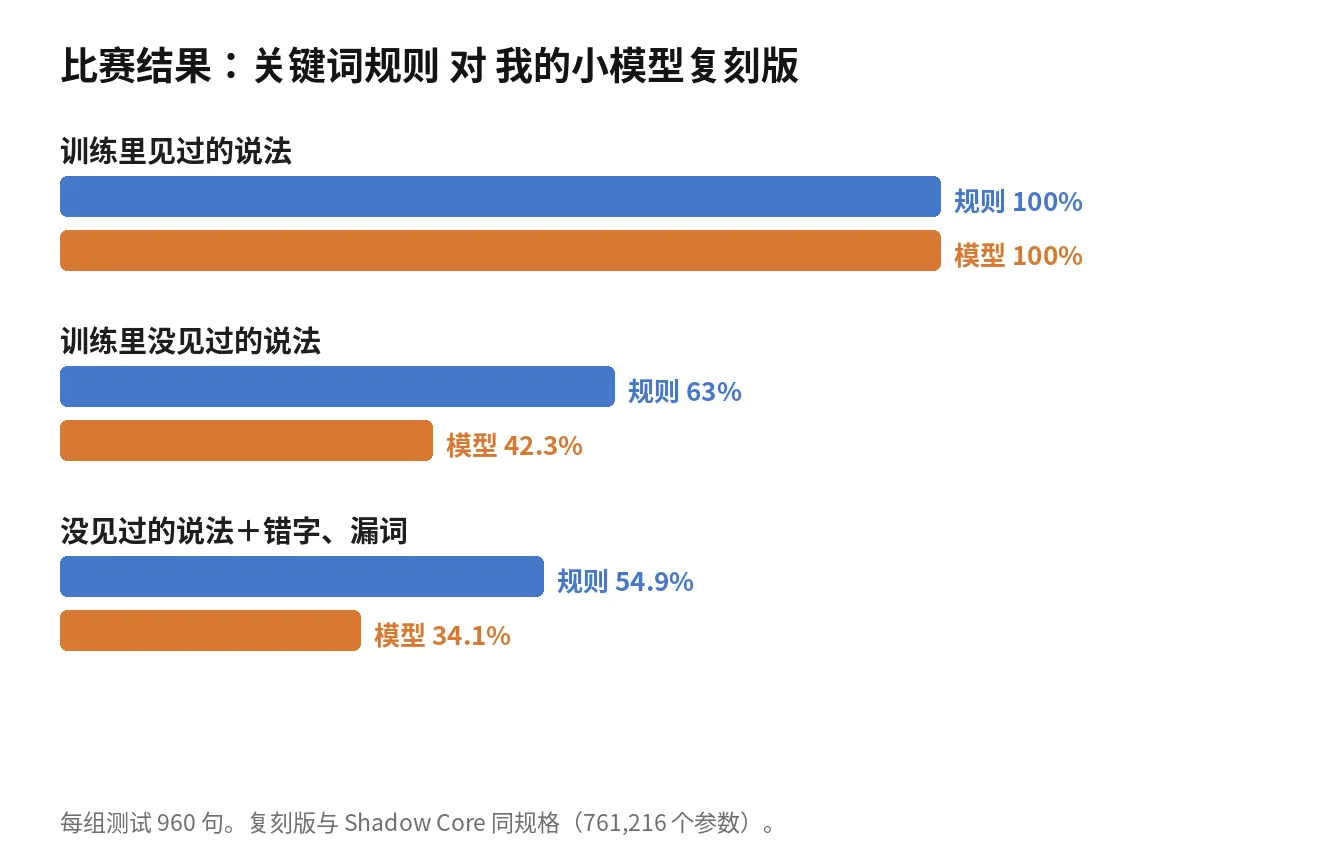
我們覺得這種小的意圖路由器值得有,就照着帖子裏公佈的規格做了一個,拿它跟一套關鍵詞規則比了一場。比賽結果:訓練裏見過的說法,兩邊都是 100%;沒見過的說法,規則 63%,我們的復刻版 42%。
我們爲什麼想要一個這麼小的意圖路由器
你對着一個助手說話,每句話在辦成之前,都先要過同一道小判斷。你說「定個十分鐘的計時器」,它得知道這是計時器;你說「查一下丹佛明天的天氣」,它得知道這是天氣;你說「打開我昨天改的那張表格」,它得知道這是開文件。
先讀懂一句話想辦什麼事,再把這句話送到對應的工具,這一步叫意圖路由。意圖,說的就是這個人想把什麼事辦成。
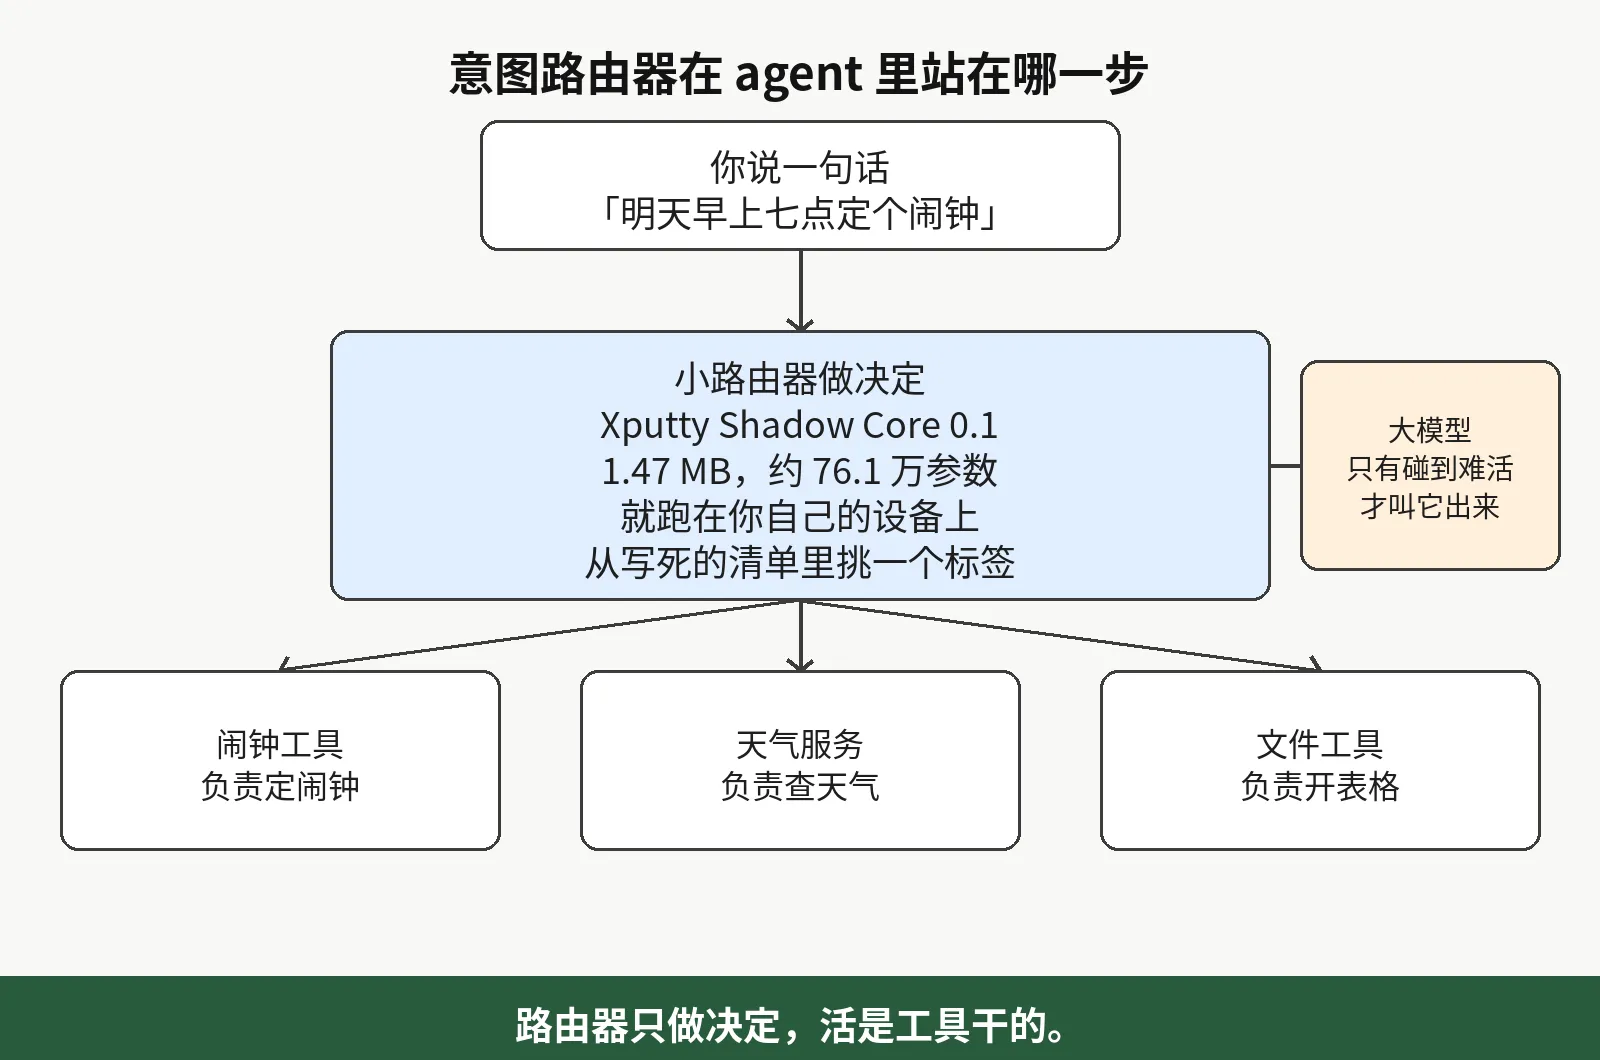
這一步現在多半是幹正事的那個大模型順手做的,我今年拆過的 agent 軟件基本都是這樣。一個幾十億參數的大模型讀完「定個計時器」,回一句「計時器工具」,事情才接着往下走。
每句話都要完整調用一次大模型,慢。調用要聯網,斷網就停。那句話還得先離開這臺設備,才能被分個類。
意圖路由器要是住在設備本地,這三件事就都不存在。它幾毫秒出結果,沒信號的地方也能跑,飛機上、地下室裏都行。用戶的話不用離開這臺機器,就能分好類。
如果是你個人使用,那麼一天也就是調用大模型幾次,其實無所謂的。但是如果是一個語音設備,或者是一個多人用的 agent,那麼每天可能要處理成千上萬次,這個成本就很大了。所以我們需要做的是把大多數的語句在本地進行處理,真正需要動腦子的部分才調用大模型。
把一句話分進一張固定清單,是語言軟件裏很老的一件事,小模型幹這個已經很多年了。2016 年 Facebook 的 fastText 就能把文本分進標籤,模型壓縮之後只有幾百 KB。
2024 年的 RouteLLM 是 LMSYS 和加州大學伯克利分校做的,決定一個問題該送給強模型還是便宜模型。它試過的辦法裏有 BERT 分類器,BERT 是 2018 年的一個小語言模型,當年主要用來給文本分類;也有一個查表的辦法,先看歷史記錄裏哪類問題通常哪個模型贏得多。
所以 Shadow Core 想做的事並不新鮮。新鮮的問題只有一個:文件做到這麼小,還能不能把這件事辦好。這個問題不用猜,測一測就知道。
引出這一切的那個文件
GGUF 是 llama.cpp 那套生態給本地模型用的文件格式,能跑 GGUF 的軟件不用寫新代碼就能加載這種文件。帖子裏把規格列得很全:
- 架構:Llama,3 層,4 個注意力頭
- 嵌入維度:128,也就是每個 token 都存成一串 128 個數字
- 前饋寬度:320,是每一層中間那張表的大小
- 參數:總共約 76.1 萬
- 詞表:762 個 token。token 是模型讀文本的單位,一塊文本常常是一個詞,或者一個詞的一部分;詞表就是它認識的全部文本塊
- 數字的存法:大多用 F16 存,一個數字佔 2 個字節;層歸一化用 F32 存,一個數字佔 4 個字節。層歸一化是一小串數字,作用是把每一層算出來的數值拉回正常範圍
- 上下文長度:160 個 token,一次大約讀一小段指令
- 張量:總共 30 個。張量就是文件裏存數字的一張表,這個數字是說,全部參數分裝在 30 張表裏
- 文件大小:1,542,912 字節,約 1.47 MB
帖子裏說的 76 萬參數,我們按規格自己重算了一遍。詞嵌入表是每個 token 一行 128 個數字,762 個 token,共 97,536 個參數;輸出表和它一樣大,又是 97,536 個。
每一層裏,四張注意力表合計 65,536;前饋部分有兩張 128 乘 320 的表和一張 320 乘 128 的表,合計 122,880;再加上兩條歸一化向量,256。一層是 188,672,三層是 566,016。
把兩張大表和最後一條歸一化向量加上去,總數 761,216,跟帖子裏說的對得上,張量數也正好 30 個。規格本身沒有對不上的地方。我們的復刻版按同樣規格導出成 GGUF,1,539,520 字節,張量同樣 30 個。
復刻版和它的對手
復刻版和公佈的規格一一對齊:同樣的架構,同樣的大小,參數總數也是 761,216。它讀文本是一個詞一個詞讀的,詞表有 762 個位置,訓練句裏只出現過 228 個不同的詞,剩下的位置都是空的。
我們給了它 16 種意圖,都是家裏的和辦公室的助手天天要處理的:定計時器、定鬧鐘、查天氣、打開文件、在網上搜索、在自己的文件裏搜索、發消息、打電話、放音樂、記筆記、設提醒、開燈、關燈、讀新聞、翻譯、報時。
訓練數據是 5,120 句用模板生成的話,時間、城市、人名、文件名在句子之間換着來。我們一直訓到它把這批訓練句全部背下來爲止。
對手是一套關鍵詞規則,你可以把它看成「一堆 if 判斷」被認真整理過一遍的樣子。每種意圖佔有一批關鍵詞,取自復刻版訓練句裏出現過的詞。打分時看這個詞出現在哪幾種意圖的句子裏。一個詞只在一種意圖裏出現,打分時這個詞得分就高;十六種意圖裏到處都有的詞,得分就低。來了新句子,把每個詞的得分按意圖加起來,總分最高的那種意圖就贏。這裏面沒有學習,也沒有要訓練的東西,開發者一個下午就能寫出來,之後用戶每說出一句新說法,就再往規則裏補一條。
比賽結果
三組測試,每組 960 句。第一組的說法和訓練裏的一樣,只是換了新的時間和人名,規則 100%,復刻版 100%。
第二組的說法全部沒在訓練裏出現過,同一件事換一種說法。規則 63.0%,復刻版 42.3%。
第三組拿第二組的句子改錯字、刪詞,弄成語音識別輸出的那種樣子。規則 54.9%,復刻版 34.1%。
我們還餵了 12 句跟 16 種意圖全不沾邊的話:「法國的首都是哪」「寫一首關於月亮的詩」「陪我下棋」「股市明天會漲嗎」。12 句全被分進了某個意圖,因爲它只會一件事:從清單裏挑一個標籤。
「股市明天會漲嗎」被分去查天氣,把握度 1.00,是它能給出的最高值。「陪我下棋」也是查天氣,0.94;「法國的首都是哪」變成了打開文件,0.97。12 句裏大約一半把握度低於 0.90,另一半在 0.90 以上,照樣全錯。
它爲什麼輸
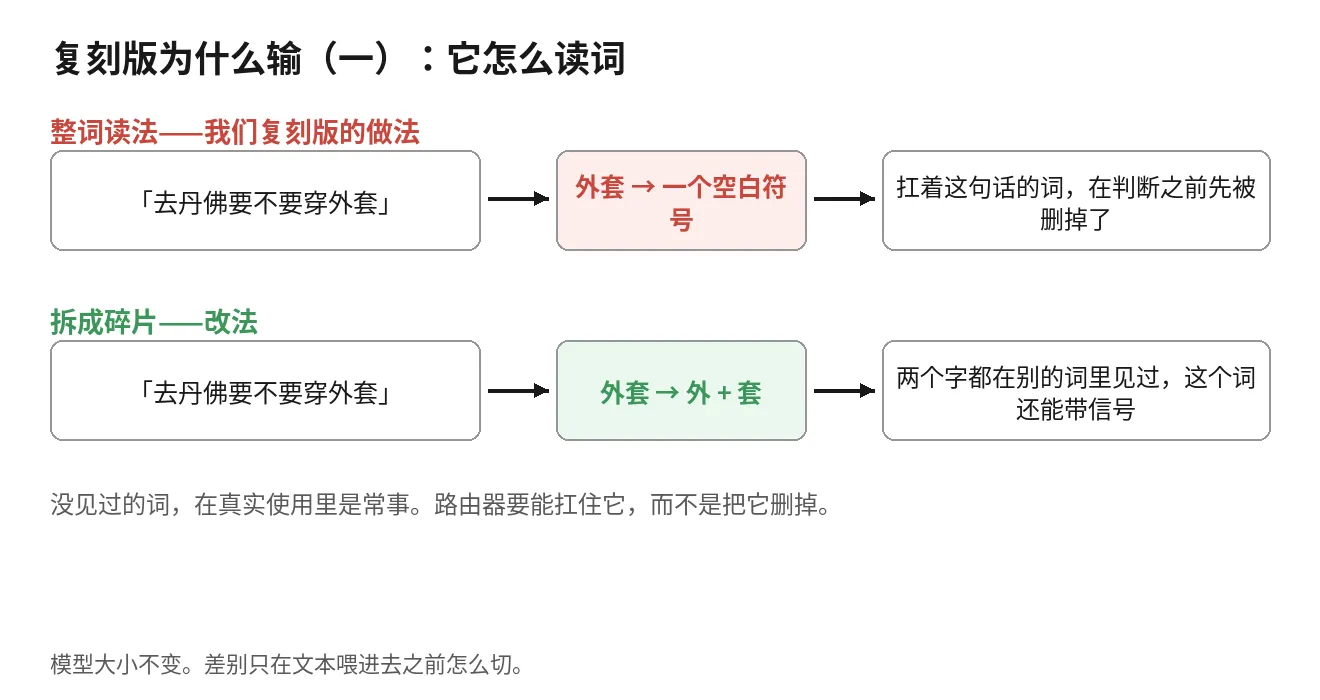
第一個原因,它按整詞讀文本。訓練裏沒出現過的詞,到它那裏就變成一個空白符號,這個詞帶的信息,在它做判斷之前就先被刪掉了。
舉個例子:「去丹佛要不要穿外套」是一個查天氣的問題,這句話裏最關鍵的詞是「外套」。我們的復刻版沒見過「外套」,這句話送到它面前的時候,最有用的詞已經先被拿走了,剩下的詞撐不起一個正確判斷,它只能猜。
第二個原因在訓練數據的來路。5,120 句全部出自模板,花樣是佔位符的花樣:同一副句子骨架,換時間、換城市、換人名。它把這些骨架學得很好,見過的說法能拿 100%,原因就在這裏。
真人說話的骨架比模板多得多。碰到沒見過的骨架,它手裏能抓的詞很少。它學下來的是我們寫模板的習慣。真人怎麼把一句話說成一個意圖,它沒學到。
規則贏在這件事上:人換說法的時候,真正承重的詞通常不動,計時器、鬧鐘、天氣、打電話還是那幾個詞。關鍵詞規則只給這些詞打分,句子是什麼骨架,它不在意。
這一場比的是我們的復刻版。訓練數據是我們自己用模板生成的那 5,120 句,分詞也是整詞。原帖那個文件可能訓得比我們好得多,這場結果不能算到它頭上。
這類路由器該怎麼訓
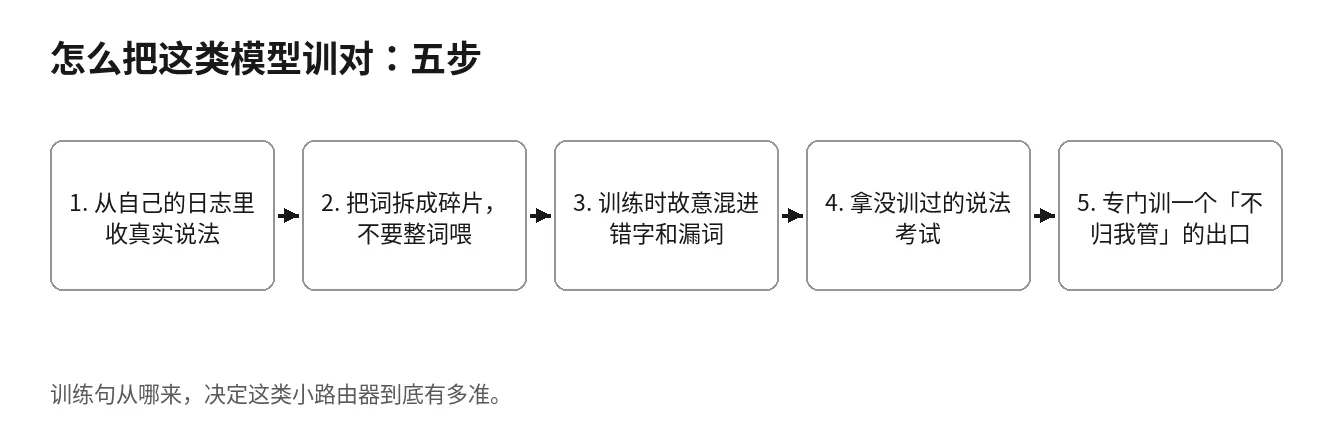
訓練句要從真實使用裏來。你的用戶實際打出來、說出來的話,從你的日誌裏收,邋遢的說法也要留着。每種意圖的說法花樣越多越好,花樣的多少正是模板給不了的東西。
合成句子只能在開始的時候用。只拿合成句子訓的路由器,見到第一個真用戶就會露怯,真人的說法一變它就跟不上,跟我們的復刻版在留出測試裏的表現一樣。真實說法是這類模型的原材料,原材料不對,後面都白搭。
分詞要把詞拆成碎片,不要整詞喂。一個沒見過的詞,拆開之後,到模型面前的是它認識的碎片:「外套」可以拆成它在別的詞裏見過的部分,這個詞就還能帶一點信號,不會直接變成空白。
整詞閱讀就是外套那個例子裏栽的跟頭,改成碎片分詞就能拿掉它,模型大小不用變。原帖那個文件的詞表也是 762,碎片詞表可以是這個大小,我們這種整詞的小詞表也可以是這個大小,光看這個數字,分不出它是哪一種。我們的整詞結果,推不到它頭上。
訓練的時候,要把髒輸入一起訓進去。真實輸入有錯字、有漏詞、有說一半的話,從語音識別過來的尤其明顯。拿出一部分訓練句,照着這個樣子弄髒:換個字、刪個詞、截掉詞尾,再拿去訓。
在訓練裏見過髒樣子的模型,會把髒輸入當成正常輸入處理。我們的復刻版只見過乾淨模板,輸入一髒,分數就從 42.3% 掉到 34.1%。
測試的時候,要把整種說法留出來考它,不能只隨機扣句子。隨機扣下來的句子,可能跟訓練句是同一副骨架,輕鬆就能過。整種說法扣下來考,它沒見過這種說法,考出來的分數才說明它能不能處理新說法。
考完還要逐個意圖看它把什麼跟什麼搞混。拿助手舉例,在自己的文件裏搜和在網上搜,任何路由器都容易混。知道自己混在哪,你就知道該去哪補數據,哪些意圖要多加一道確認。
還要教它說「這句不歸我管」。能進生產環境的路由器,必須有一個清單之外的出口。做法是把清單外的話也當成一類,專門拿來訓練,讓它學會拒絕,而不是每句話都硬分一個意圖。
爲什麼不能只靠把握度定一條線?我們的復刻版就是現成的例子:它清單外分錯的那些話裏,大約一半把握度在 0.90 以上。有了訓出來的拒絕出口,再加一條拿留出數據定好的把握度線,清單外的話纔會被轉交出去。
這類路由器該怎麼用
擺法是小路由器在前,大模型在後。沒被路由器拒掉、把握度又高於那條線的句子,在本地直接完成處理,不用再交給後面的大模型。這樣一次只需要幾毫秒。我們的復刻版在我們自寫的測試程序裏、跑在一臺小云服務器上,一次大約 9.5 毫秒。
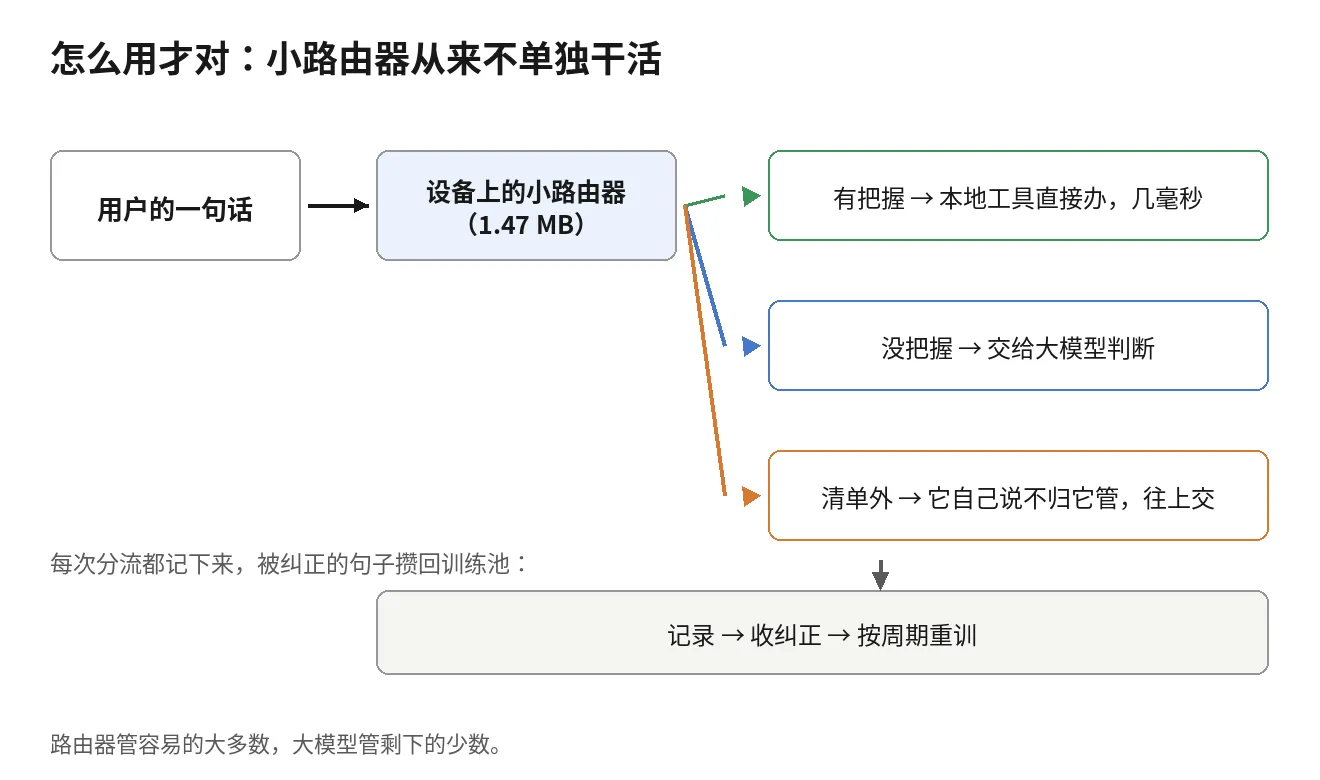
剩下的句子,沒把握的和被它拒掉的,往上交給大模型。大模型慢,調用一次還要花錢。可是難的句子只有它能想明白,所以該往上交的還是要往上交。本地的路由器管的,是容易的、大批的那些句子。
每一次判斷都記下來。被大模型推翻的,被用戶糾正的,那句話和它正確的意圖一起進訓練池,路由器按週期重訓。路由器剛上線時只能粗粗分一遍,用得越久,它越清楚你的用戶習慣怎麼說話。這件事沒有任何外來文件能替你做。
有一類動作不能讓路由器直接放行,就是那些做錯了收不回來的動作。放錯一首歌,再換一首就是了,沒什麼損失。可是消息一旦發出去就收不回來,文件刪了、錢付了也一樣。這類動作,不管路由器多有把握,都要先停下來,讓人確認了再做。
碰到這類意圖,路由器可以把動作先準備好,最後拍板要有一個確認步驟,或者一條寫死的規則檢查。把握度多高都一樣,這一步不能省。
說法能列全的地方,不要用路由器:操作員受過訓練、只說固定命令詞,或者一臺設備上一共就十幾個按鈕。那種地方用規則,壞了也好查。路由器該用的地方,是說法花樣多、還不斷冒出新說法的地方。普通人對着機器說話,用的都是自己的說法,就是這種場合。
回到引出這一切的那個文件
這種路由器該有,這一點我們的測試是支持的。Shadow Core 這個文件做得好不好,是另一件事,我們給不出分。
一個路由器做得對不對,看三樣東西:它的意圖清單、它怎麼切詞、它拿什麼樣的說法訓練。這個文件三樣都沒有公開。文件本身沒有放出下載。元數據是作者自己讀的,按他讀出來的結果,裏面沒有作者名字,沒有許可證,也沒有訓練說明。
作者本人也還沒展示過它運行的樣子。他在帖子最後說,他打算去看看自己跟 Grok Build 能拿它做點什麼。也就是說,帖子發出來的時候,試驗還沒開始做。
這個文件要是按對的方法做的,拿真實說法訓練,分詞拆成碎片,拒絕出口也訓了,它在真的助手裏面完全可能派得上用場。可是它到底是不是這樣做的,上面那三樣東西都沒有公開,我們沒辦法覈對;文件又沒有放出下載,也沒有人演示過它運行,它分得準不準,同樣沒有人測得了。
它做得好不好,我們確認不了,所以我們不會把它裝到自己要負責的系統最前面。真需要這樣一個路由器,我們就自己做一個:訓練材料用自己日誌裏的真實說法,大模型兜底從第一天就接好。
你自己跑的東西里面,有沒有這樣一步:一個大模型讀一句很短的話,回一個工具的名字?你的用戶都是怎麼說這些請求的,那些說法,你這週能從日誌裏收出來嗎?收說法這件事做好了,這類模型其他部分纔有得做。我平時就喜歡拆這種小模型和 agent 裏的管道活,你要是覺得這種拆法對你有用,歡迎訂閱或者收藏這一頁,後面還會接着拆。