你給 agent 挑模型的時候,是先看每百萬 token 的價目表,還是先算一個任務跑完要花多少錢?這兩個問法只差一句話,可是算出來的貴賤能差出好幾倍。
11 月 9 日,Meta 發佈了 Muse Ember。它是從 Muse Wonder Full 蒸餾出來的,專門給 agent 每天重複跑的任務用,像工具調用、編碼子任務和長文解析這一類。
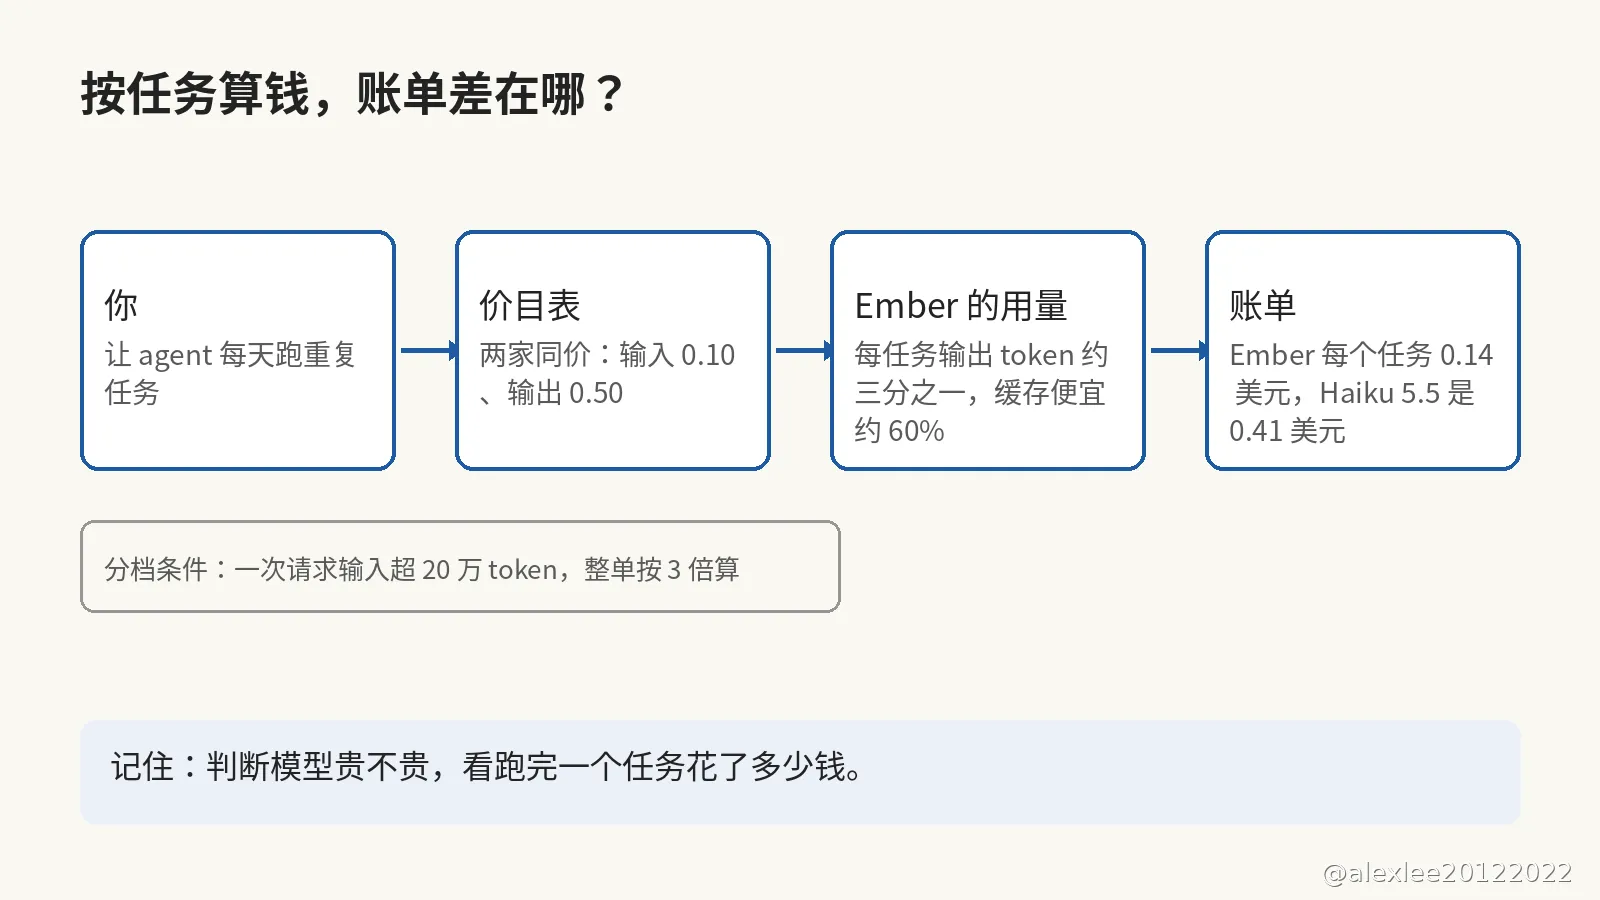
Ember 的價目表是這樣的:一次請求輸入不超過 20 萬 token 的時候,輸入和輸出分別是每百萬 0.10 美元和 0.50 美元、緩存輸入是每百萬 0.004 美元。可是 Haiku 5.5 的輸入和輸出價錢和它一模一樣,輸入也是 0.10 美元、輸出也是 0.50 美元。所以,只看價目表的話,兩個模型一樣貴。
Artificial Analysis 換了一個量法:它不看價目表,而是讓每個模型把同一批任務真的跑一遍,再記下每個任務實際花了多少錢。
在它的智力指數上,Ember 和 Haiku 5.5 都是 36 分,可是每個任務的價錢差了三倍:Ember 是 0.14 美元、Haiku 5.5 是 0.41 美元。Muse 家自己的 Spark 1.3 分數更高一點(37 分),可是它每個任務要花 2.39 美元,相當於 Ember 的 17 倍。
既然價目表是同一張,賬單爲什麼能差出三倍?因爲賬單不是照着價目表的單價收的,而是照着你實際用掉多少 token 收的,而兩個模型用掉的量又不一樣。差別先出在輸出上:Ember 每個任務寫出的 token 只有 Haiku 5.5 的三分之一左右,而輸出的單價又是輸入的五倍,所以光是往外寫的這一部分,賬單就能差出一大截。
輸出之外,賬單還差在緩存這一項上。重複的任務每跑一遍,都要把同一份上下文再讀一遍,如果這份上下文已經緩存住了,再讀就按緩存輸入的價錢算。Ember 緩存輸入的價錢,比 Haiku 5.5 緩存輸入的價錢便宜約 60%,所以一個任務重複的次數越多,緩存在賬單上省下的就越多。
假定一個 agent 每天把同一個任務跑 1,000 次,再把每個任務的價錢乘上這個次數:Ember 一天是 140 美元、Haiku 5.5 是 410 美元,而 Spark 1.3 是 2,390 美元。這筆賬是我自己乘出來的,不是任何一家公佈的賬單。
Meta 在發佈文裏還引用了一組 AutomationBench 的數字。這個評測考的是模型能不能把一整套業務流程從頭跑到尾,百分數就是跑通的流程佔多少:Ember 跑通了 37.8%,Haiku 5.5 只跑通了 13.9%(這是 Meta 在發佈文裏引用的、我沒自己復跑的數字)。兩個模型跑的是同一批流程,Ember 跑通的比例反而更高,所以它每個任務更便宜,不是因爲它每個任務的工作量更少。
不過,這份便宜是有條件的:條件就寫在價目表的分檔裏。Ember 的上下文能裝下 100 萬 token,可是裝得下不等於一直便宜。如果一次請求的輸入超過 20 萬 token,那麼整單就改按三倍的價錢收:輸入每百萬 0.30 美元、輸出 1.50 美元、緩存輸入 0.012 美元。
所以不要把整個代碼倉庫一次塞進一個請求裏,先把材料切小了再喂。因爲超線之後,整單都按三倍算,前面那 20 萬 token 也跟着一起漲。真要喂長上下文,先算一算這一單漲三倍之後還值不值得。
agent 的搭法也該跟着變了:兩類任務要分開搭。每天重複跑的任務,就交給 Ember 這種按任務算便宜的模型,因爲這類任務量大,而且每天都要跑很多遍,所以哪怕單件只省一點,攢起來也是大頭。真正難的判斷一年也遇不上幾次,遇上了就留給 Wonder 或者 Spark 這種更強的模型,因爲如果判斷錯一次,損失比省下的那點 token 錢大得多。
我的建議是,先不要急着換。你先挑一個自己天天在跑的重複任務,再讓 Ember 和你現在用的模型各跑一遍。兩個模型都跑完之後,你再比一比兩邊各花了多少錢,比完之後才決定換不換。因爲價目表只能告訴你每個 token 多少錢,而你真正要付多少錢,要等任務跑完了才知道。
如果這篇對你有用,請訂閱或收藏這個博客。我會繼續分享 AI、安全和開源方面自己動手查過、用過的東西。以後再有新模型發佈,我還是先算它跑完一個任務要多少錢,再回頭看它的價目表。
來源:Meta 官方發佈,見 https://x.com/finkd/status/2119851180948152590