大家用 agent,都是這麼用的
用 agent 做事,現在很多人都是同一個流程。agent 做着做着跑偏了,你指出來,它改。一次就完全按你的要求做對,基本指望不上,因爲 agent 本來就不是許願機。
等事情做完,你還會讓它再總結一遍。它把這次哪裏做錯了、哪裏卡住了,一條一條復盤出來。復盤出來的東西,一般就直接讓 agent 寫進項目裏,或者寫進 agent 自己的核心約束文件,下次做事起手就帶着。還有人再往前一步,把這些話蒸餾成 skill。
這麼做的目的很直白,就是下次別再犯同樣的錯。下個項目、下個任務一來,agent 能少繞一點路,做得更準一點,也更順一點。
有人把復盤搬上實驗臺驗了一遍
這個習慣聽着很順,順到很少有人回頭問一句,它到底有沒有用?最近就有人把這件事搬上實驗臺,認認真真驗了一遍,結果和大多數人的預期對不上。
Treude 和 Baltes 兩位研究者先讓 Claude Code 跑完 30 個修 bug 的任務,然後讓它回頭復盤。復盤只問一個問題:這套跑法哪裏要改?它一共提了 125 條改進建議。
復盤用的東西叫 /retro,就是跑完一個任務之後,讓 agent 把整個會話從頭看一遍,再提出改 harness(跑 agent 的那套東西:軟件、配置、還有給 agent 的指令)的建議。改 harness,就是改 agent 下次做任務時的起手配置。
實驗用的是 SWE-bench Verified 裏的 30 個任務,這些任務都是真實倉庫裏的真實 issue。125 條建議先被一條一條分類。研究者從裏面挑了 24 條,並且真的裝了上去。再從這 24 條裏挑 12 條,就拿到後面的任務裏對照着驗。
驗的辦法是對照。針對同一個倉庫的後續任務,開兩個全新的會話。其中一個帶上這條改動,另一個不帶,然後比一比,看看帶改動的那邊是不是真的少做了改動要消掉的那個動作。
12 條拿去驗的改動,先被篩掉 5 條,因爲不帶改動的對照組那邊根本沒遇到它要修的那個問題。如果沒有對照組,這 5 條看起來會像沒出問題,其實是沒被驗過。剩下 7 條裏,2 條把那個動作徹底消掉了。另外 1 條讓這個動作出現得少了,剩下的 4 條一點變化都沒有。
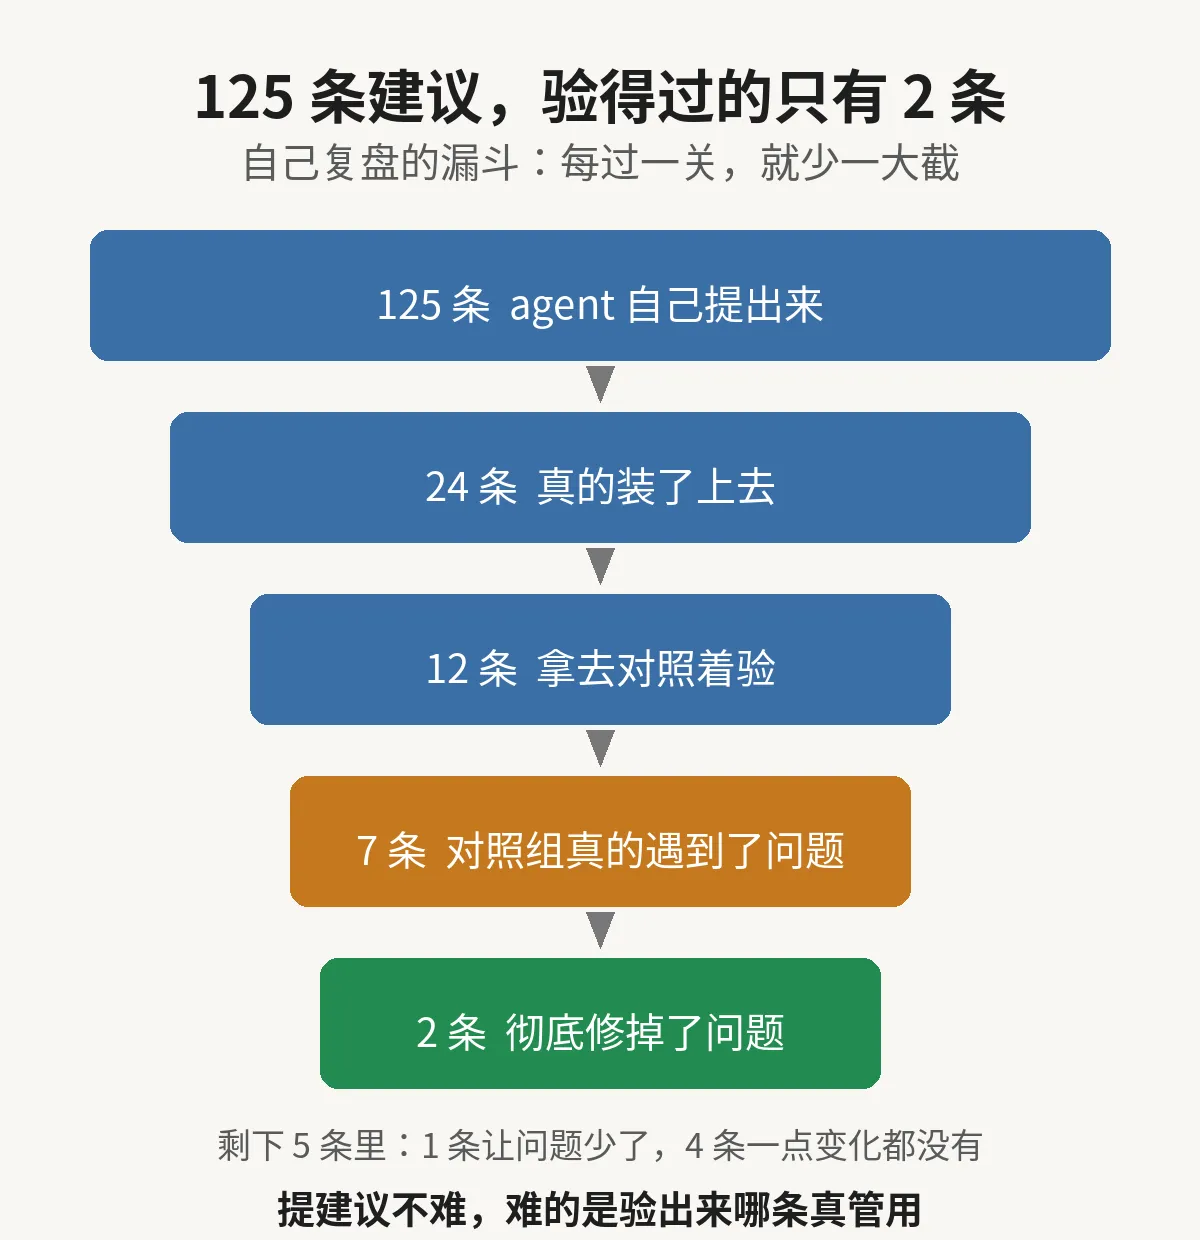
所以回到開頭那個問題,復盤總結不是一條都不能用。12 條裏,確實有 2 條把問題徹底消掉了,還有 1 條讓問題出現得少了。提建議時一口氣提了 125 條,最後驗得過的只有這麼幾條。
125 條建議,爲什麼大多沒用
建議本身的質量也有問題。125 條裏和 lint 有關的有 43 條,其中 18 條是不管每次任務裏到底發生了什麼,都推薦同一個做法。這樣的建議並不是從證據里長出來的,而是 agent 把自己認定的做法又說了一遍。
還有些改動幫了倒忙。論文裏寫了,有些改動反而讓 agent 在無關的任務上多做了事。改動裝上去之後沒人再驗它,它就一直在那裏。以後 agent 每次跑任務,都要多做一點額外的事。
問題不在 agent 提了多少建議。問題在它審的是自己剛做完的任務。它只能從自己的視角看自己剛做完的任務,所以它覺得這次卡住的地方下次就該改。可是卡住的地方是一回事,該改的地方是另一回事。
如果沒有對照組,agent 就分不清兩件事:改動是真修了它要修的那個問題,還是那個問題本來就不會再出現。靠自己審自己,這兩件事就分不清。上面那 12 條裏,就有 5 條卡在這裏,連驗都沒驗成。
上面那 18 條就是模板話的樣本。一條建議如果換一個任務還會原樣出現,它就和這次任務裏到底發生了什麼沒有關係。你把這樣的話存進經驗,下次讀到的還是這句現成的話,這次的證據並沒有跟着一起存進去。
改動撤不掉,就會越堆越多。agent 跑起來,也就離原來的做法越偏。而且每多一條沒驗過的改動,無關的任務就可能跟着多做一點事。
如何做纔是正確的
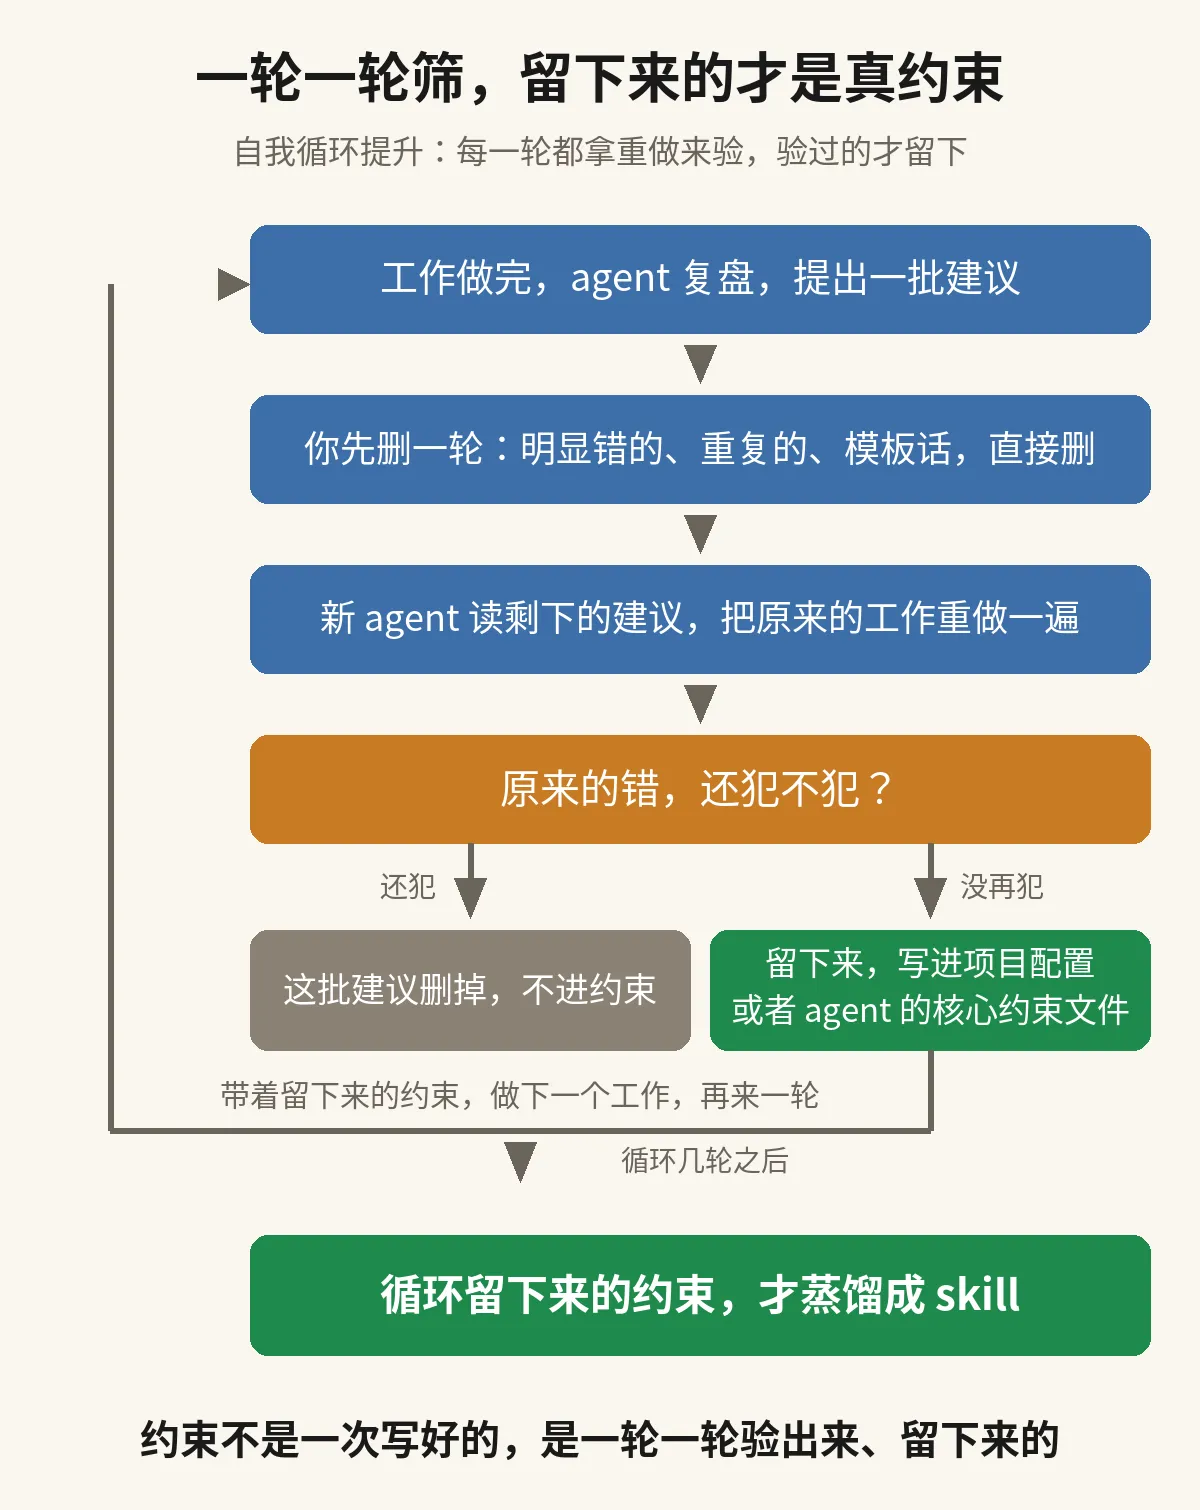
第一步,你自己先把這份復盤過一遍。有開發經驗的人,掃一眼就知道哪幾條不對勁:明顯寫錯的、和前面重複的、換個任務照樣成立的模板話,直接刪掉,不用留到後面驗。這一步花的是你自己的經驗,幾分鐘就過完了,剩下的纔是接下來要驗的。
第二步,把剩下的建議交給一個新的 agent 驗。開一個全新會話,還是原來那個項目。把剩下的建議寫進項目配置裏,讓它先讀完,再把你剛剛做完的那個工作重做一遍。跑的人是它,你不用在旁邊記賬,也不用等下一個任務出現。
第三步,看重做的結果。你當時指出過的那些錯,這次還犯不犯,一眼就看得出來:沒再犯的,這批建議裏有東西是真管用的;照樣犯的,說明留下來的建議沒起作用。拿不準的時候,再開一個不帶建議的會話把同一個工作跑一遍,兩邊一比就清楚了。論文裏用的就是這個辦法,只不過他們比的是後面的任務。
第四步,按結果定去留。重做時錯沒再犯的,這批建議就留下來,寫進項目配置或者 agent 的核心約束文件,長期留着。照樣犯錯的,刪掉,不要留在配置裏佔位置。想要分清是哪一條起的作用,就把建議拆成一條一條,照這個辦法再跑一遍,研究里正是一條一條驗的。
下一個工作來了,就帶着留下來的約束再走一遍:新的復盤出來,再刪一輪、再重跑一遍驗。一輪一輪循環下去,約束會越來越乾淨。最後能蒸餾成 skill 的,就是這麼循環幾輪還留下來的那一批。
蒸餾成 skill,放在最後一步
等建議照上面這個辦法驗過、確定重做時錯沒再犯,再把裏面真正起作用的寫進 skill。寫的時候把那次重做記一筆:原來錯出在哪裏、重做時有沒有再犯,後面的人接手時能直接看到它憑什麼留下來。
agent 復盤時寫下的原文不進 skill。原文裏混着沒驗過的判斷,也混着換個任務照樣成立的模板話。能進 skill 的,是從原文裏挑出來、先刪過一輪、又重跑驗過的那幾條,而且寫進去的時候要改寫成規矩、帶上那次重做的記錄。原文整份搬進去,等於把沒驗過的東西也一起搬了進去。
論文最後的結論也是這個意思:生成改動、裝上改動只是第一步。還得有辦法知道改動在後面的任務上到底幫沒幫上忙,也得有辦法修正、撤掉那些沒用的改動。
如果你也在讓 agent 自己復盤、自己總結,還想把總結蒸餾成 skill,這篇裏的驗法可以直接套在你自己的配置上。麻煩點個贊,再關注一下。這類實測我後面還會繼續發。
來源:Treude 與 Baltes 的論文《How Do Coding-Agent Harnesses Self-Evolve?》,arXiv:2610.34938,https://arxiv.org/abs/2610.34938
#AIAgents #LLM #AIEngineering