11 月 13 日,llama.cpp 發了 1.0.0(發佈頁:https://github.com/ggerganov/llama.cpp/releases)。自家 API 一次刪掉了 35 個廢棄函數。warmup 函數和 defrag 選項不在這 35 個之內,是另外拿掉的。
同一個版本里,推測解碼的 NextN API 從擴展頭文件升進了正式的 llama.h。刪舊函數和升正推測解碼放在同一個版本里,1.0 這個版本號的意思就清楚了:它不是功能清單變長了,而是公開 API 從此有了合約。
刪掉的 API
0.x 的時候,API 是可以隨便動的。維護者先把函數標上廢棄,然後留着不刪,最後讓調用者慢慢換。
1.0 把這些留着不刪的廢棄函數一次結清了。
如果你的程序調了這些函數,升級之後編譯直接失敗,而且不會有過渡期,也不會先給警告頂着。
廢棄函數留着,所以維護者要替新寫法和舊的廢棄寫法兩套背書。文檔也要寫兩份。而且新人進來先看到的就是過時的寫法。要改的只有調用這一處:所有直接調這些函數的程序,升級之前必須先把調用改掉。改完這一次調用,之後就不用再爲這 35 個函數改了。
FP8 的 KV cache
1.0 另一個改動在顯存上。模型每吐一個 token,都要把算這個 token 時用的 key 和 value 存下來,爲的是下一個 token 接着算的時候,不用把前面的話重算一遍。這份存下來的東西就叫 KV cache。對話越長,KV cache 佔的顯存就越多。
以前 KV cache 按 FP16 存,也就是一個數佔兩個字節。1.0 加了 FP8 的選項,也就是一個數只佔一個字節。按字節算,同樣一張卡,FP8 的 KV cache 能裝的量比 FP16 翻了一倍。對話能拉的長度也跟着翻倍。
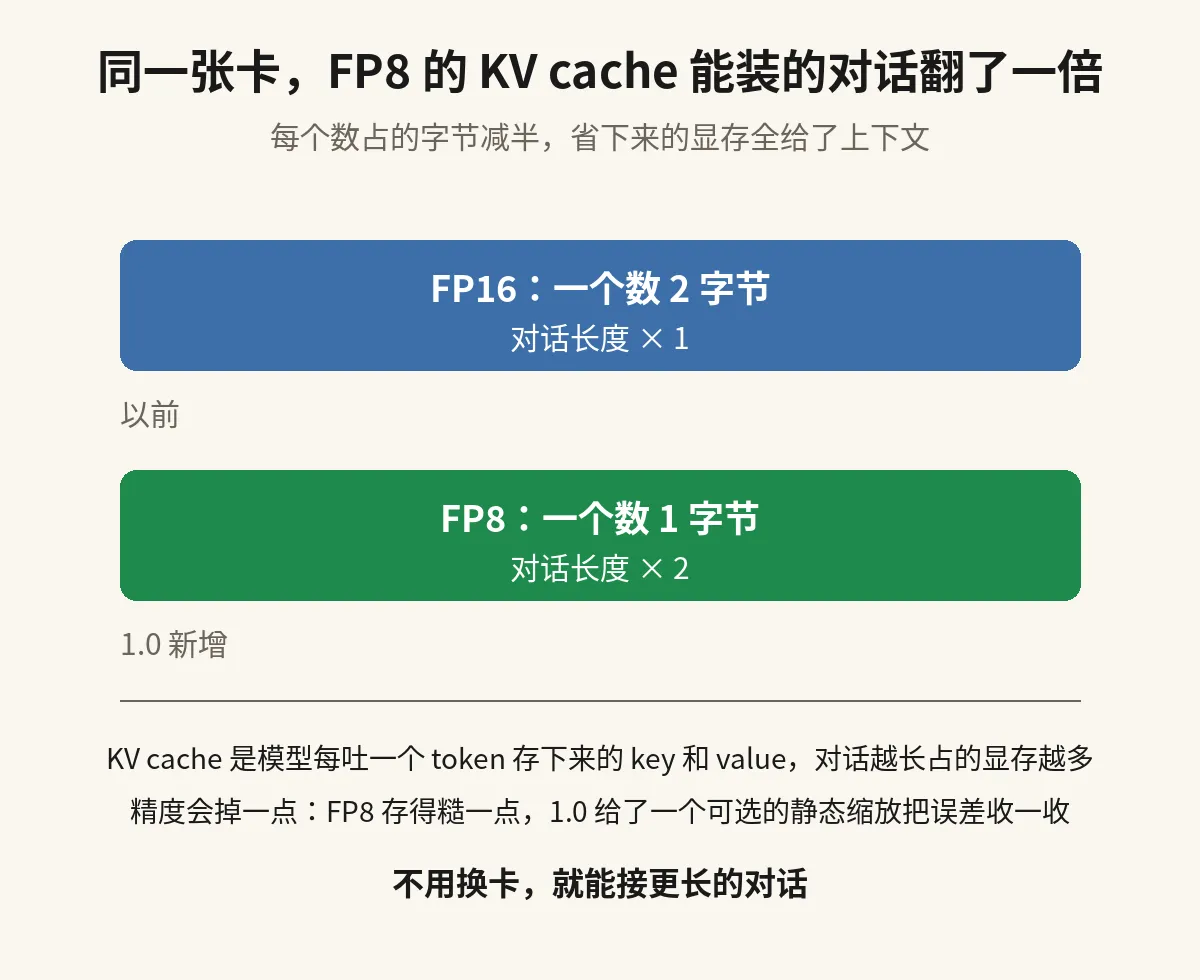
FP8 存得糙一點,所以精度會掉一點。不過發佈頁給了一個可選的靜態縮放:給每個張量單獨配一把尺,存之前先按這把尺把數值縮到 FP8 裝得下的範圍裏,誤差就收得更小。
這筆賬對跑本地模型的人最實在。顯存不夠的時候,瓶頸常常不是模型本身有多大,而是對話一長,KV cache 就先於模型把卡塞滿了。
FP8 等於讓同一張卡裝下兩倍長的對話,所以不用換卡,就能接更長的對話。
升正的推測解碼
推測解碼是另一件從擴展升成正式 API 的東西。做法是讓一個小模型先往前猜幾個 token,再讓大模型一次驗過。猜對的,大模型就直接收下;要是猜錯了,大模型只重算錯的那一個 token。猜比算便宜,所以同一個請求花的時間就少了。
以前這套 API 放在 llama-ext.h 裏,是擴展。1.0 把它升進 llama.h,成了正式公開 API 的一部分。擴展和正式 API 的區別只有一個,就是能不能隨便改:擴展可以改,而正式 API 不能隨便改。升正的意思就是,推測解碼以後是 llama.cpp 保證不會隨便改的用法,不再是擴展頭文件裏那個隨時能改的東西了。
加固的 server
1.0 還修了 llama-server 的安全問題。修掉的包括三樣:一個是 CORS 配置的洞,一個是 DNS rebinding,還有一個是經由 CORS 中轉的 SSRF。MCP 工具調用也在這一版改了:客戶端一斷開或者超時,llama-server 就把調用取消,還會告訴 MCP server,調用已經取消了。
這些修補沒有一個是新功能,但是它們修的都是 server 跑在網上的部分。有人把 llama-server 掛在局域網裏跑,有的甚至掛到公網上。模型本身跑得再好,服務器端留一個 SSRF 的洞,別人還是能拿這臺服務器去探內網。這一版等於把門先關上,再談別的。
1MB 的桌面 App
同一個版本還發了一個 1MB 的桌面 App,叫 llama.app(https://llama.app)。離線能跑,也就是不用聯網,而且不用按月付費。想在自己機器上跑模型的人,門檻又低了一級。
升級之前先查什麼
所以 1.0 的升級順序應該是這樣。先查自己的程序有沒有調那 35 個被刪的函數,有就先改掉。再看自己的對話長不長,長就試試 FP8 的 KV cache。最後看 llama-server 是不是掛在網上跑,掛着就升這一版。按這個順序升,升級之後就不用再回頭改調用了。
如果你也在自己機器上跑模型,升級之前先把那 35 個函數查一遍,查完再升。這篇要是能幫你少返一次工,麻煩收藏一下,再訂閱這個博客。我會繼續寫自己動手查過和測過的東西。